

SYNCULAR : un SQLite local par client, un seul journal serveur
⏱️ Temps de lecture estimé : 4 minutes
📌 syncular est un moteur de synchronisation offline-first : chaque client garde une vraie base SQLite locale, et un journal de commits autoritatif côté serveur réconcilie tout, écritures hors ligne comprises.
Le chemin de lecture d’un produit offline-first est réglé depuis des années : on met les données dans SQLite, on requête en local, on rend. Benjamin Kniffler considère que le chemin d’écriture est la partie dure, et il a de quoi le prouver — il a construit debe, un datastore réactif avec sync CRDT, en 2019, jamais arrivé en production. Sept ans plus tard, il a publié une analyse de PowerSync, Zero, Electric, TanStack DB, Replicache, Turso, LiveStore et Jazz. syncular est l’architecture sortie de cette comparaison.
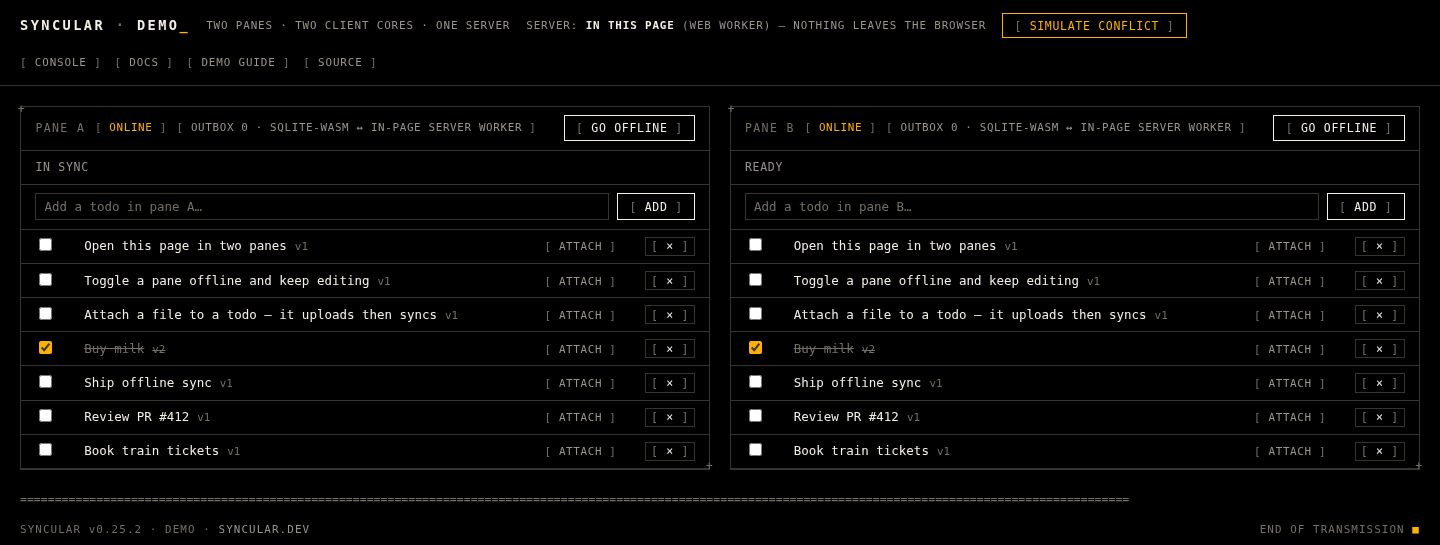
Concrètement, voici ce que vous écrivez. Chaque client — un onglet, un iPhone, un worker Flutter, un processus Rust — possède une vraie base SQLite. Vos lectures sont du SQL ordinaire, avec jointures, agrégats et index, sans aller-retour réseau. Une écriture passe par mutate, qui applique la ligne localement et l’ajoute à un outbox durable dans la même transaction : la ligne apparaît immédiatement, et le processus ne peut pas s’arrêter entre les deux. Au retour du réseau, l’outbox part en commits idempotents, dans l’ordre de création.
Là où beaucoup d’outils vous demandent d’apprendre un langage de règles, syncular vous demande une fonction. resolveScopes(actor) vit dans votre backend, à côté de votre authentification, et renvoie les valeurs que l’acteur peut voir. Le manifeste déclare le routage par table — "scopes": ["list:{list_id}"] — et le serveur intersecte demandé et autorisé, en lecture comme en écriture. Les colonnes de scope sont immuables dans une mise à jour initiée par le client : impossible de déplacer une ligne vers un périmètre que l’on contrôle.
Les conflits sont explicites et optionnels, ce qui est plus rare qu’il n’y paraît. Un patch peut porter un baseVersion : « applique seulement si les colonnes que je présente sont encore celles que j’ai éditées ». Le serveur compare uniquement les colonnes présentes, pas la ligne entière, et renvoie un conflit qui nomme conflictColumns et contient déjà la ligne serveur. Deux éditions sur des colonnes disjointes passent donc les deux. Et la cohérence se choisit colonne par colonne : last-write-wins par défaut, colonnes CRDT Yjs pour du texte collaboratif, colonnes chiffrées qui restent des ciphertext pour le serveur.
Ce que je trouve rafraîchissant, c’est la méthode plutôt que la liste de fonctionnalités. Le protocole SSP2 est écrit noir sur blanc, et il existe deux implémentations indépendantes : un core TypeScript qui tourne dans un Web Worker sur OPFS avec sqlite-wasm, et un core Rust sur rusqlite exposé par une FFI C de cinq fonctions. Les deux passent les mêmes vecteurs dorés au niveau octet et les mêmes 183 scénarios de conformance, en CI. Un écart de comportement entre plateformes ne peut pas se dissimuler dans un détail d’implémentation.
Le bootstrap ne rejoue pas l’histoire. Un client neuf télécharge un segment image SQLite attaché puis copié : environ 30 ms pour 100 000 lignes en loopback in-process, contre 363 ms par la voie décodage de lignes. Le chiffre est flatteur et le site le dit — votre déploiement ajoute le réseau et la sérialisation. Côté poids, le code syncular pèse 31,3 KB gzip, le reste étant le wasm de SQLite.
Deux nuances avant de vous lancer. syncular est en pre-1.0, maintenu par une seule personne, sous licence Apache-2.0. Et le modèle assume ses bornes : un serveur, un journal ordonné, pas de pair-à-pair. Zero, à titre de comparaison, refuse explicitement les écritures offline longues ; syncular les accepte et vous laisse trancher.
Mon avis : la partie la plus difficile à vendre est celle que personne ne met en avant. Écrire le protocole avant le code, avec deux implémentations qui doivent être d’accord, c’est la seule façon sérieuse d’éviter que votre « couche de synchronisation » devienne un oasis de bugs selon les plateformes. Le prix est explicite : la dénormalisation des scopes, et le fait que votre application reste propriétaire de la gestion des conflits. Pour des données applicatives durables, c’est un pari que j’aime bien. Pour du netcode image par image, la documentation le dit sans détour : ce n’est pas la bonne couche.
- 🗄️ Une vraie base SQLite par client, lectures en SQL local
- 🔐
resolveScopes(actor)s’écrit dans votre backend - 🧪 183 scénarios de conformance partagés par les deux cores
- 📦 Bootstrap par image SQLite : 100k lignes en ~30 ms en loopback
- ⚖️ Conflits détectés colonne par colonne, seulement si vous demandez
baseVersion - 👤 Pre-1.0, un seul mainteneur, Apache-2.0
Sources