

IAMSPEAKER : répètez vos présentations avec un coach IA 100 % local
⏱️ Temps de lecture estimé : 3 minutes
https://github.com/spark798/iamspeaker
📌 IAMSPEAKER est une application web open source d’entraînement à la prise de parole. On lui donne ses slides, l’IA joue d’abord le talk à votre place, puis analyse votre propre enregistrement : débit, mots de remplissage, prononciation, intonation. Tout tourne en local, avec Ollama, Whisper et Piper, sans clé API.
Répéter une présentation seul, tout le monde connaît : on parle trop vite, on lâche quarante « euh », et personne n’est là pour le mesurer. Les coaches IA de ce type existent en SaaS, mais vos enregistrements partent alors chez un éditeur, derrière un abonnement. IAMSPEAKER prend le problème par l’autre bout : transcription, synthèse vocale et LLM tournent chez vous. Slides, enregistrements, analyses : tout reste dans votre dossier data/.
Le détail qui change tout arrive au début du flux. Plutôt que de vous enregistrer à froid, l’outil écrit un script à partir de vos slides — affiné avec des principes issus de livres de prise de parole — puis le joue avec une voix de synthèse, slide par slide, à côté du visuel rendu. Vous voyez d’abord à quoi peut ressembler un talk abouti sur votre propre contenu. Ensuite seulement, vous prenez le micro.
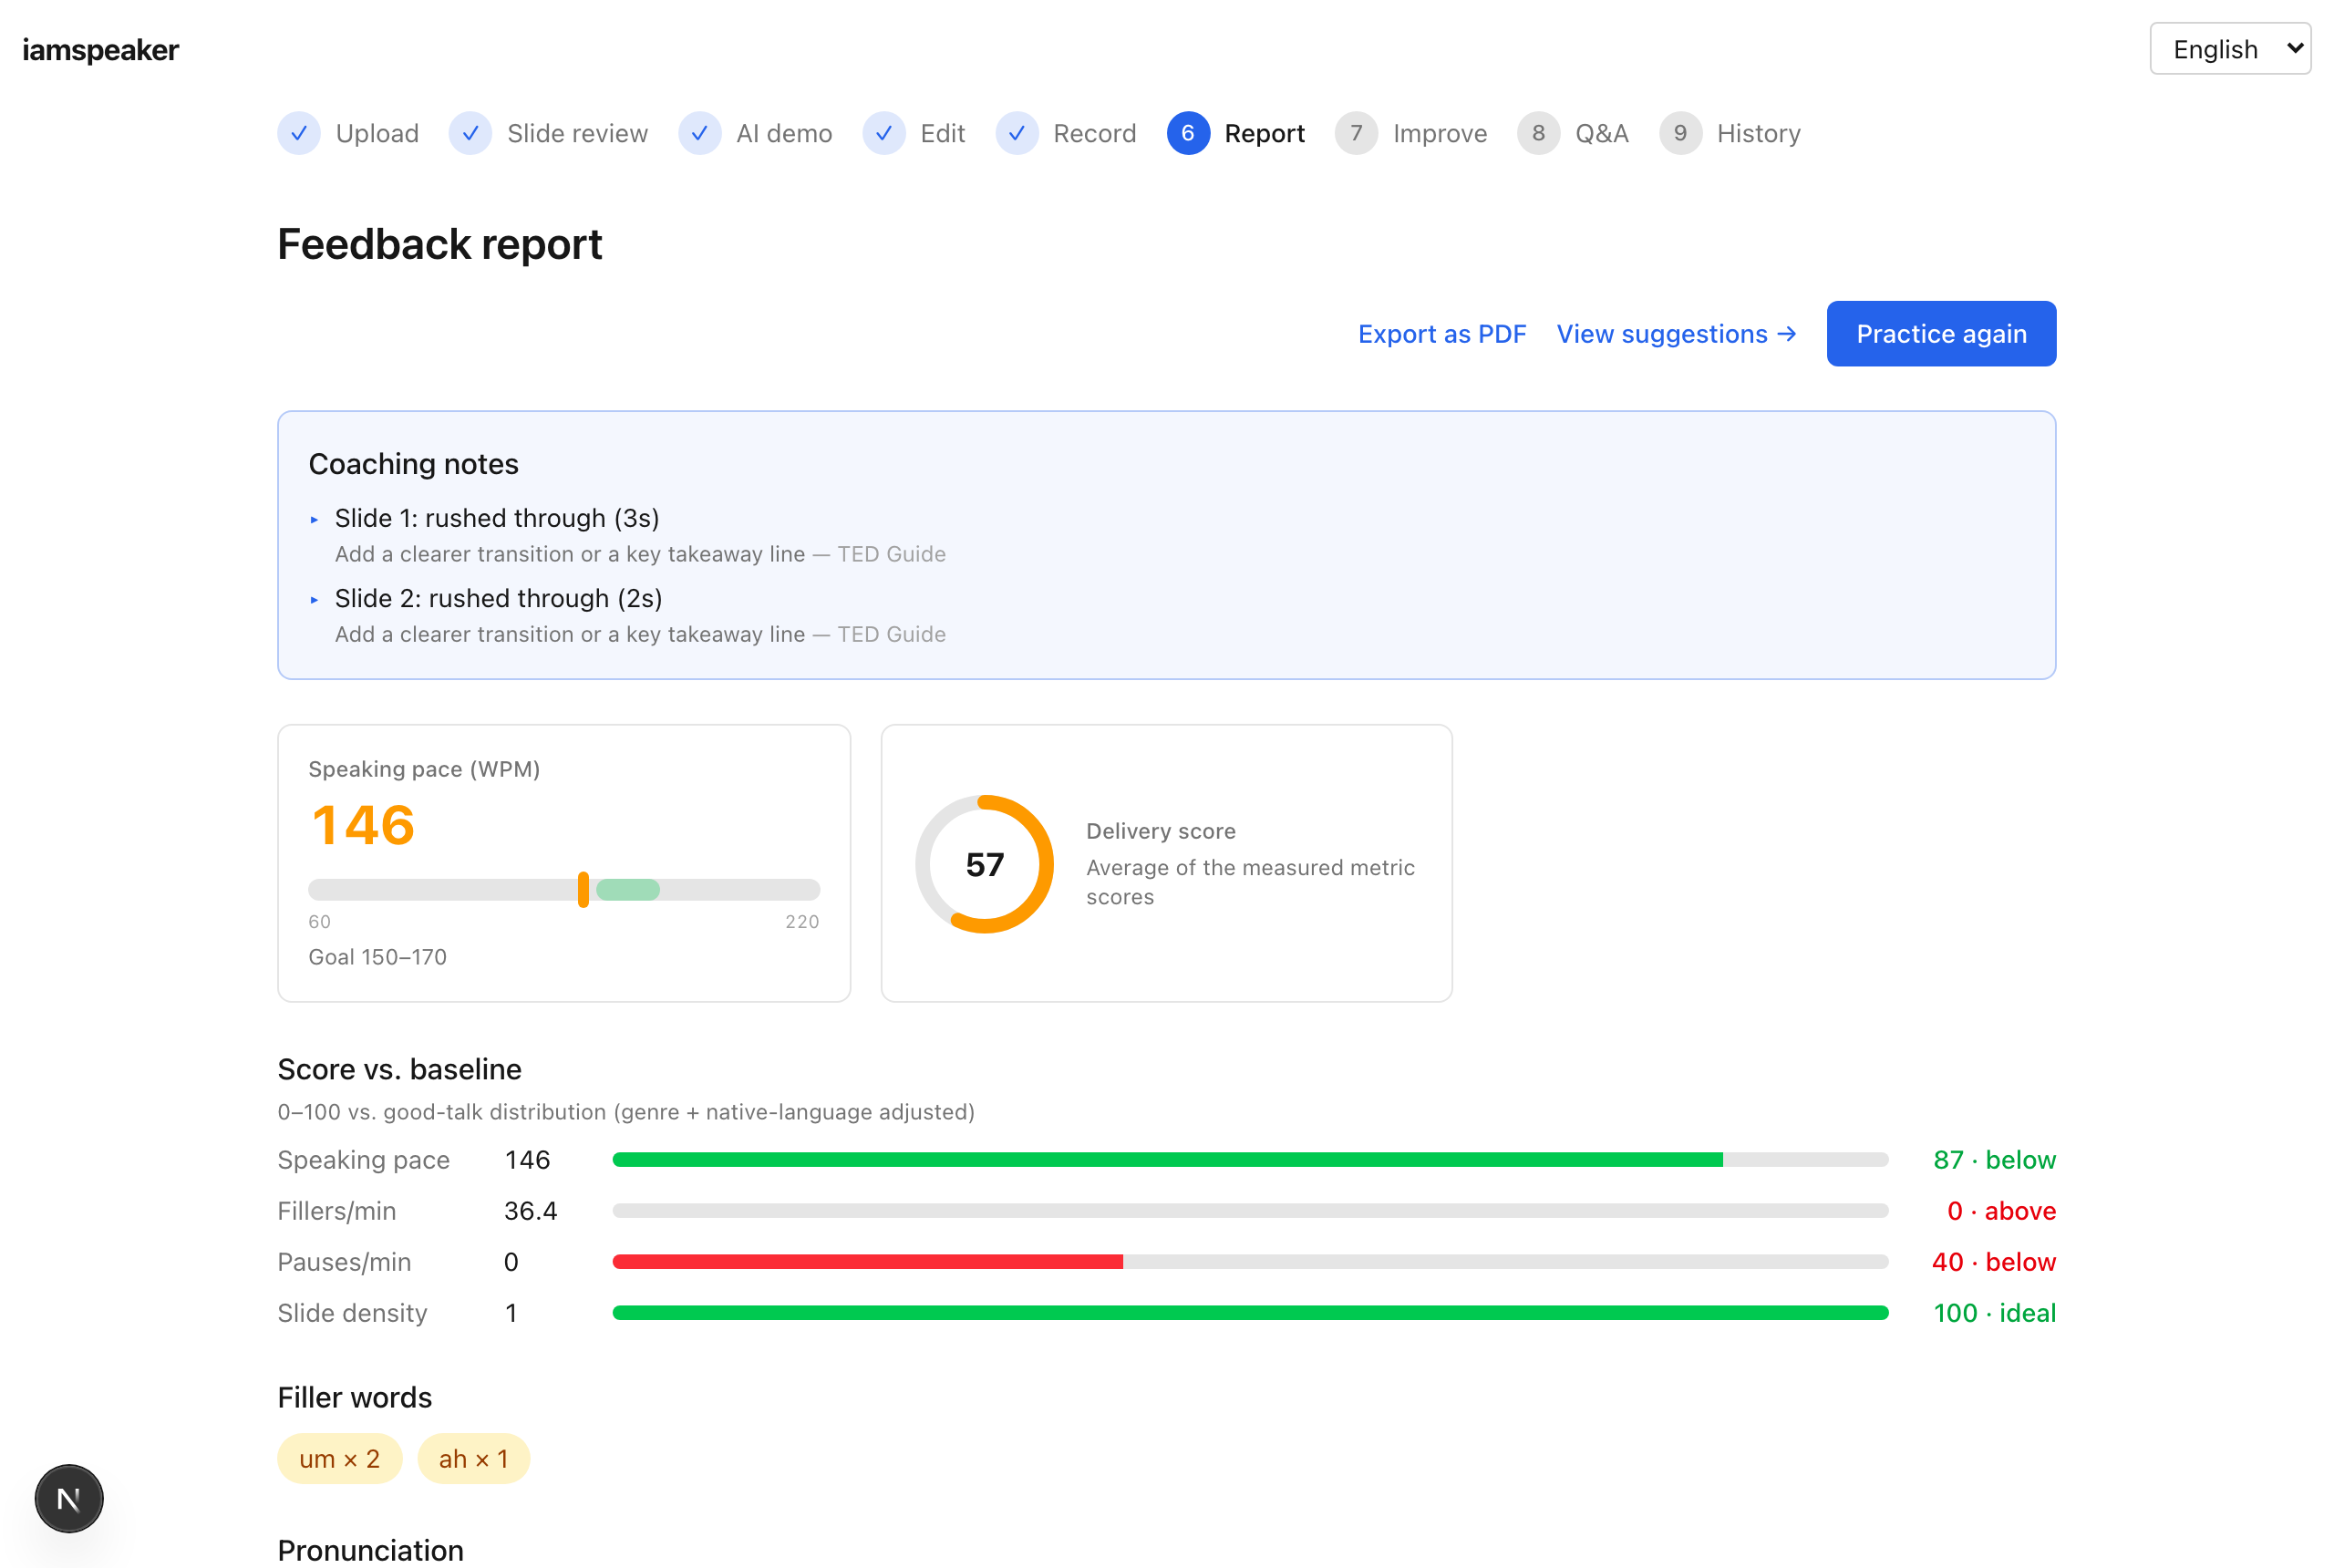
Après votre passage, le rapport est précis : vitesse de parole en WPM, mots de remplissage par minute, score de prononciation phonème par phonème, détection d’intonation monotone, répartition du temps par slide. Les notes de coaching sont prescriptives — elles disent où et quoi corriger — et s’exportent en PDF. La version 0.5.0 ajoute le repérage du vocabulaire qui affaiblit la crédibilité, la traduction du script, une voix et des sous-titres SRT dans une langue cible.
- 🎤 L’IA écrit et joue le talk à partir de vos slides, avant votre propre passage
- 📊 Un rapport chiffré : WPM, mots de remplissage, prononciation phonème par phonème, intonation
- 🔁 Une boucle d’entraînement complète : objectifs, tendances, comparaison prise par prise
- 🌍 Script traduit, voix et sous-titres SRT dans votre langue cible
- 🔒 Slides, enregistrements et analyses restent dans votre dossier data/
Je trouve l’approche « la démo d’abord » bien vue : elle remplace la page blanche par un exemple concret, ce qui vaut pour les non-natifs comme pour les autres. Et le choix du local n’est pas cosmétique — contrairement à un SaaS, vous adoptez n’importe quel nouveau modèle Ollama le jour où il sort.
Deux limites à connaître. La qualité dépend du modèle : le llama3.1:8b par défaut se contente de 8 Go de RAM mais produit des scripts courts et des traductions moyennes ; le projet recommande qwen2.5:14b, qui demande 16 Go. Et le scoring de prononciation précis (wav2vec2, en option) peut signaler à tort des mots bien prononcés sur des accents marqués — les auteurs l’assument et conseillent de se fier au score global.
L’installation passe par Docker (docker compose pull, puis up -d), image multi-arch, application sur le port 3000. Licence MIT, interface en cinq langues. Un projet jeune, donc perfectible, mais qui traite un vrai problème sans envoyer votre voix dans le cloud.