

COGNEE : la mémoire qui survit à vos sessions d’agents
⏱️ Temps de lecture estimé : 4 minutes
📌 COGNEE est une couche de mémoire open source pour agents IA, publiée en Apache-2.0, qui transforme vos documents, votre code et vos conversations en graphe de connaissances self-hosted. Vos agents continuent de dialoguer avec le modèle que vous utilisez déjà — Claude, GPT, un modèle local — et c’est cognee qui prépare, à chaque appel, le contexte qu’ils n’auraient jamais dû perdre.
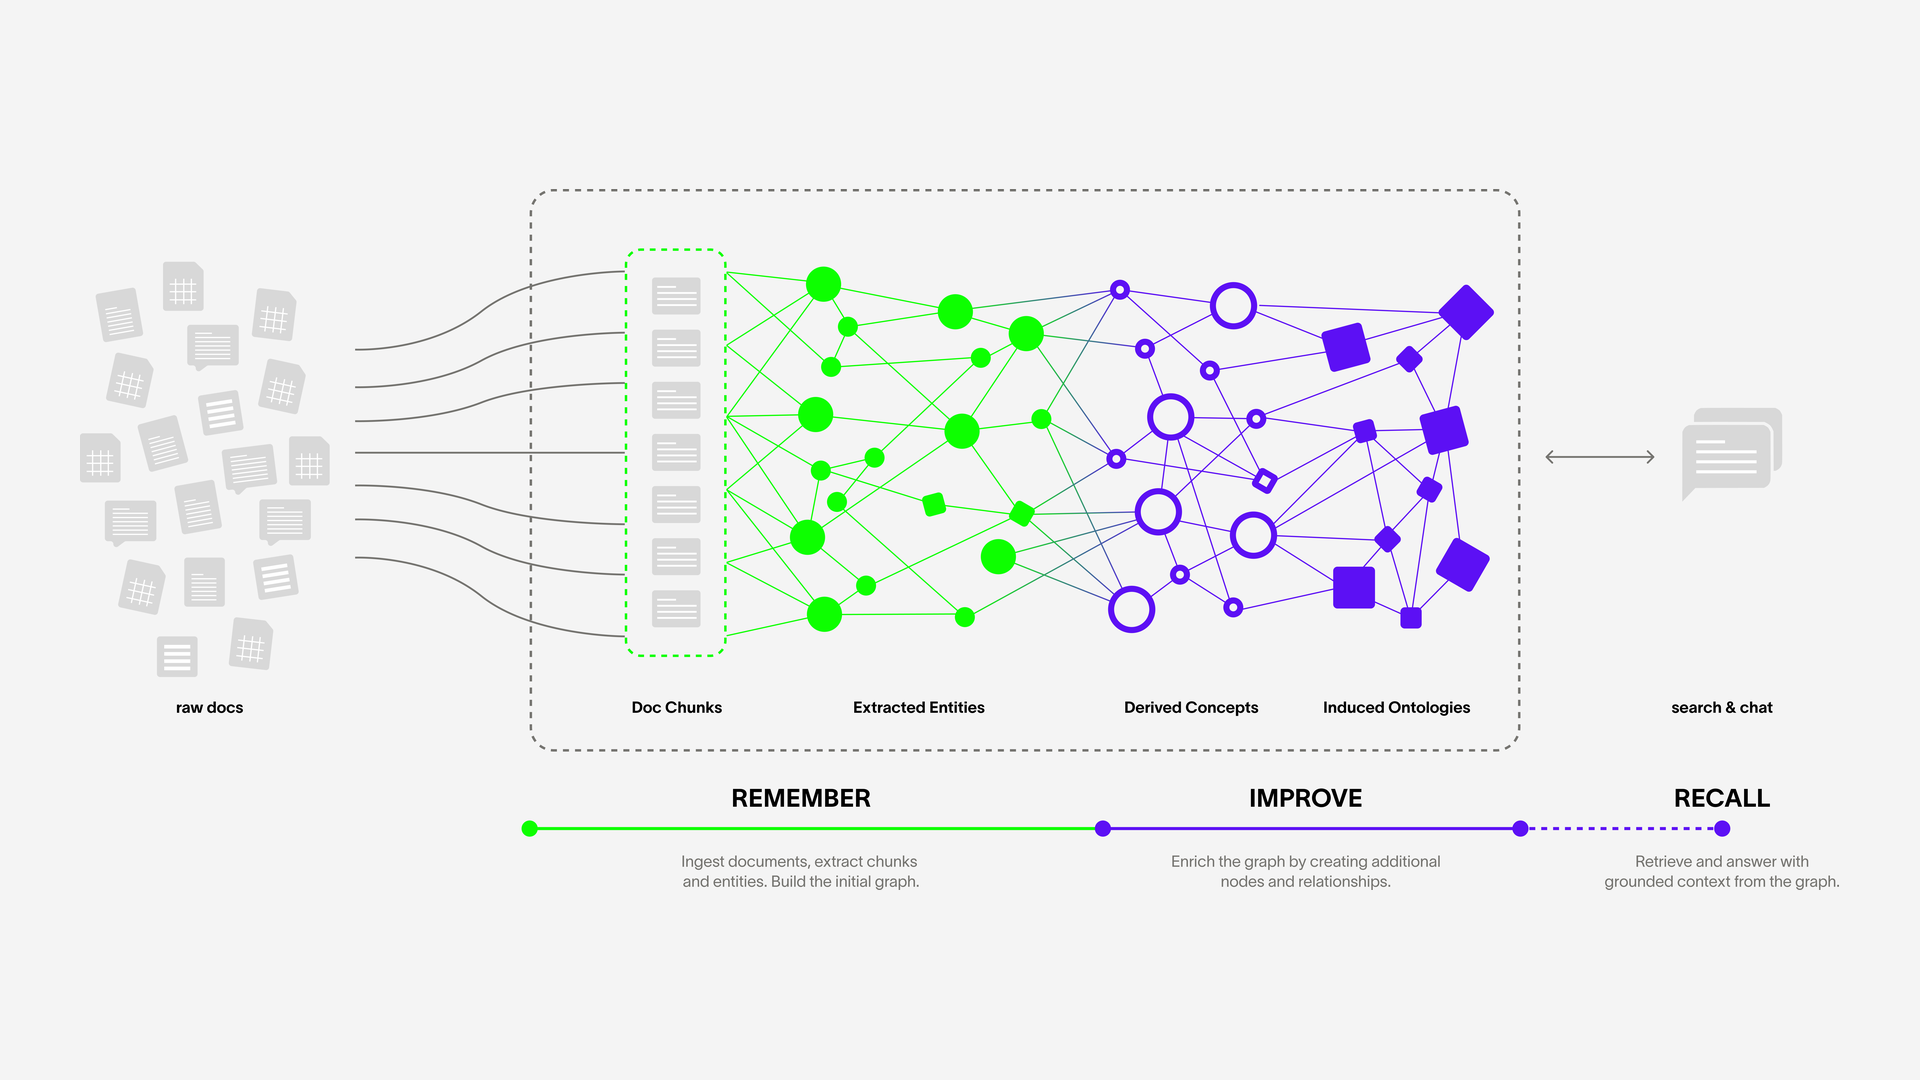
Chaque requête envoyée à un LLM repart de zéro. L’agent refait un travail accompli la semaine dernière, puis un autre, et vous payez les jetons deux fois. Cognee s’intercale entre vos données et le modèle, et quatre opérations suffisent à couvrir le cycle complet. remember ingère du texte, des fichiers ou des URL, découpe, extrait les entités et construit le graphe. recall répond en langage naturel en choisissant tout seul sa stratégie de récupération. improve enrichit un graphe existant, fait passer les leçons d’une session dans la mémoire permanente et pondère les résultats selon vos retours. forget retire un élément, un dataset, ou tout ce qui appartient à l’utilisateur courant.
Le changement de la version 1.6.0, datée du 18 septembre 2026, tient en une ligne : la clé LLM devient facultative. pip install cognee suffit désormais à indexer et à interroger du texte avec des modèles locaux — l’extraction et les embeddings ne quittent pas votre machine, et les étapes qui dépendent d’un LLM sautent d’elles-mêmes. Vous gardez votre fournisseur pour le reste, OpenAI par défaut, AWS Bedrock ou Ollama selon vos préférences. Un cognee-cli demo va plus loin encore : il charge un graphe préconstruit, lance une recherche par mots-clés et ne télécharge aucun modèle. C’est la façon la plus rapide de voir ce que l’outil produit avant de l’installer sérieusement.
Le branchement se fait par MCP, et c’est propre. Le paquet cognee-mcp embarque la bibliothèque complète : pas de seconde installation ni de backend à lancer. En mode autonome, il tourne sur SQLite, LanceDB et la base graphe embarquée Kuzu, que vous pouvez remplacer par Neo4j ou Postgres. Claude Code, Codex, Cursor, Cline, LangGraph, CrewAI, n8n ou Dify s’y connectent sans glue. Côté données, les connecteurs couvrent GitHub, Slack, Linear, Google Drive et Gmail, complétés par dlt pour le structuré et ScrapeGraphAI pour le web.
Mon avis tient dans une phrase : je trouve l’idée du graphe plus convaincante qu’un vector store nu quand un agent doit suivre des règles métier, parce qu’elle rend les relations explicites et les réponses citables. La documentation le formule d’ailleurs sans détour — cognee n’est pas un modèle, et c’est davantage qu’un RAG.
Trois réserves, en revanche. Le mode Postgres, qui réunit relations, métadonnées et PGVector sur une seule instance, est livré comme fonctionnalité de démonstration : la version prête pour la production est un produit sous licence. Le benchmark BEAM publié par le dépôt (0,79 sur 100K tokens, 0,67 sur 10M) repose sur les propres jeux de données de l’équipe, et son rapport signale un écart de reproduction restant sur l’ingestion distribuée. Enfin, l’interface locale cognee-cli -ui réclame Node.js et Docker. Le reste tient dans Python 3.10 à 3.14, sur un dépôt né en 2023 qui affiche 31 000 étoiles et 3 100 forks.
Points clés de cognee :
- 🧠 Quatre opérations — remember, recall, improve, forget — couvrent tout le cycle de mémoire.
- 🔑 Depuis la 1.6.0, l’indexation et la recherche tournent en local, sans clé de fournisseur.
- 🔌
cognee-mcpembarque tout : SQLite, LanceDB et Kuzu par défaut, Neo4j ou Postgres au choix. - 🔗 Connecteurs GitHub, Slack, Linear, Google Drive, Gmail, dlt et ScrapeGraphAI.
- 🐍 Apache-2.0, Python 3.10–3.14, 31 000 étoiles — et une migration depuis Mem0, Letta, Zep ou Graphiti.
Sources