

TYPELLM : des sorties typées pour vos workflows LLM
⏱️ Temps de lecture estimé : 3 minutes
https://github.com/TypeLLM/TypeLLM
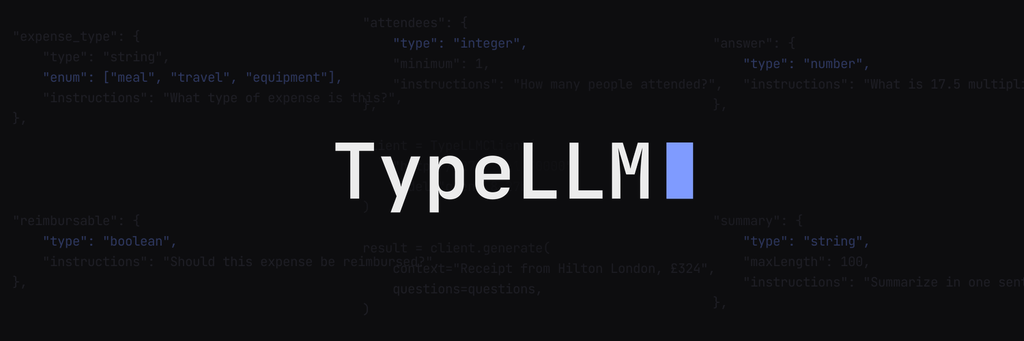
📌 TYPELLM est une couche de décodage typé pour les LLM autoregressifs open source qui renvoie du texte, des entiers, des nombres, des booléens et des choix contraints par un schéma JSON. Elle accepte aussi des images et peut enchaîner plusieurs décisions dépendantes dans un même appel.
Le post de lancement oppose TypeLLM à Jev sur trois fonctions très concrètes : Jev n’expose pas les sorties texte, entier et nombre, ne documente pas d’entrée image et traite ses questions comme des décisions indépendantes. TypeLLM ajoute ces trois couches sans modifier l’architecture ni les poids du modèle. C’est le bon angle pour le comprendre : ce n’est pas un modèle de plus, mais une couche de décodage et d’exécution posée au-dessus d’un LLM déjà servi par SGLang.
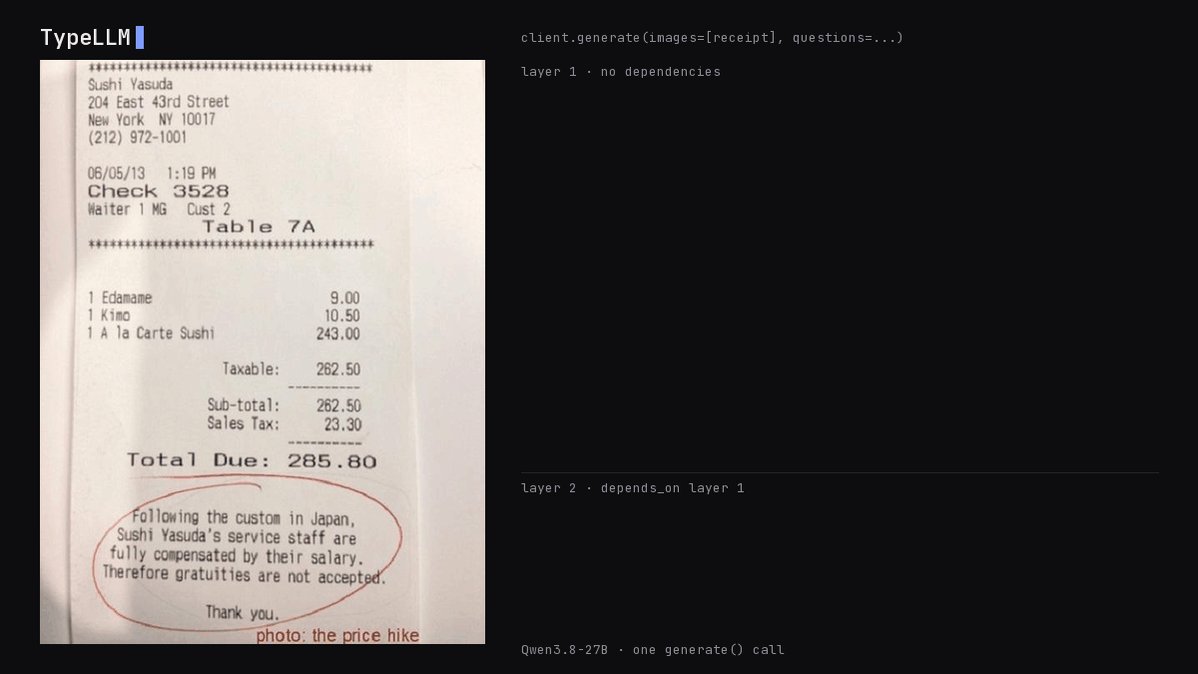
Imaginez une note de frais photographiée. Vous pouvez joindre l’image locale ou son URL, puis demander un total sous forme de nombre, un booléen pour le statut de paiement et une catégorie limitée à « meal », « travel » ou « equipment ». Le résultat arrive comme un dictionnaire Python avec les bons types, sans JSON à reparcourir ni valeur inventée hors de la liste.
Les workflows se construisent aussi dans un seul appel. TypeLLM exécute des champs indépendants en batch, les uns après les autres en mode séquentiel, ou selon un graphe avec depends_on. Dans l’exemple de son équipe support, la catégorie et l’urgence sont calculées en parallèle, puis la recommandation utilise leurs deux résultats. Le préfixe partagé reste dans le cache KV de SGLang pour éviter de retraiter inutilement le ticket.
- 🧾 Une image de ticket devient montant, statut et catégorie
- 🔗 Les étapes conditionnelles s’exécutent dans un même appel
- 🔢 Texte, entier, nombre, booléen et enum reviennent avec leur type
- 🧠 Le raisonnement optionnel peut être limité par champ
- ⚡ Les champs indépendants profitent du batch et du cache de préfixe
L’installation reste courte : pip install -U typellm, puis un TypeLLMClient pointe vers le serveur HTTP SGLang du modèle. Le projet est sous licence Apache 2.0 et cible Python 3.10 ou plus récent. C’est donc du self-hosted, mais pas sans infrastructure : il faut déjà servir un modèle compatible sur un serveur GPU, avec SGLang et le cache de préfixe activé.
Sur son propre JevBench de 231 tâches, l’équipe annonce 195 réponses correctes sans raisonnement et 228 avec le mode thinking activé. Sur un autre test avec seize booléens, le mode batch passe de 9,35 à 1,61 secondes sur un RTX PRO 6000 Blackwell. Ces chiffres dépendent évidemment du modèle, de la charge et du serveur ; ils donnent un ordre de grandeur, pas une garantie.
Je trouve l’approche convaincante parce qu’elle déplace la validation du texte libre vers la couche de décodage, là où la contrainte peut réellement être appliquée. La nuance est nette : TypeLLM ne remplace pas Jev pour tous les usages. Son tableau ne lui attribue pas de véritable API Score pour les scores de rubric, et son installation suppose un serveur de modèles déjà maîtrisé. Pour les applications qui doivent produire des valeurs fiables sans bricolage, TypeLLM me paraît plus structuré qu’une simple génération de JSON.
Sources