

BASERT : le runtime LLM local qui bat llama.cpp sur Apple Silicon
⏱️ Temps de lecture estimé : 4 minutes
https://www.basecompute.co/getbasert
📌 BASERT est un runtime d’inférence LLM local pour Apple Silicon et NVIDIA GB10 : une ligne d’installation, un CLI unique pour tirer un modèle, discuter ou le servir en API compatible OpenAI, sans quitter la machine.
Faire tourner un modèle chez soi sur Mac, c’est llama.cpp ou MLX. Les deux font le travail, et aucun n’est lent. BaseRT part d’un constat plus précis : ces runtimes paient le prix d’abstractions qui n’ont pas été pensées pour le modèle d’exécution de Metal ni pour la mémoire unifiée d’Apple Silicon. Ici, tout est écrit nativement en Metal, avec des noyaux GPU écrits à la main — et le même moteur tourne désormais aussi sur NVIDIA GB10 (DGX Spark) en CUDA.
L’usage de tous les jours tient en trois commandes. curl -LsSf https://basecompute.co/install.sh | sh pose le moteur précompilé et le CLI dans ~/.basert et l’ajoute au PATH. basert pull Qwen/Qwen3-4B télécharge depuis HuggingFace et convertit au vol, basert chat ouvre la discussion. Le hub résout trois sources par ordre de priorité : votre cache local, un catalogue de modèles .base déjà convertis hébergé sur l’organisation HuggingFace basecompute, et n’importe quel dépôt HuggingFace brut. basert convert applique le même traitement à un GGUF ou un checkpoint MLX déjà sur votre disque.
Le centre de gravité est basert serve. Vous obtenez un serveur HTTP compatible OpenAI : chat, completions, embeddings, rerank, transcription, tokenisation, tool calling, streaming, continuous batching, paged-KV et prefix caching. Les modèles se chargent et se déchargent à chaud, LoRA comprise. Le bénéfice est prosaïque mais décisif : tous vos clients OpenAI existants continuent de marcher en changeant l’URL, et aucune donnée ne quitte la machine. Pour un agent de codage, il y a même un raccourci — BaseRT sert de backend local pour pi via l’extension pi-basert, qui découvre automatiquement les modèles que votre serveur expose.
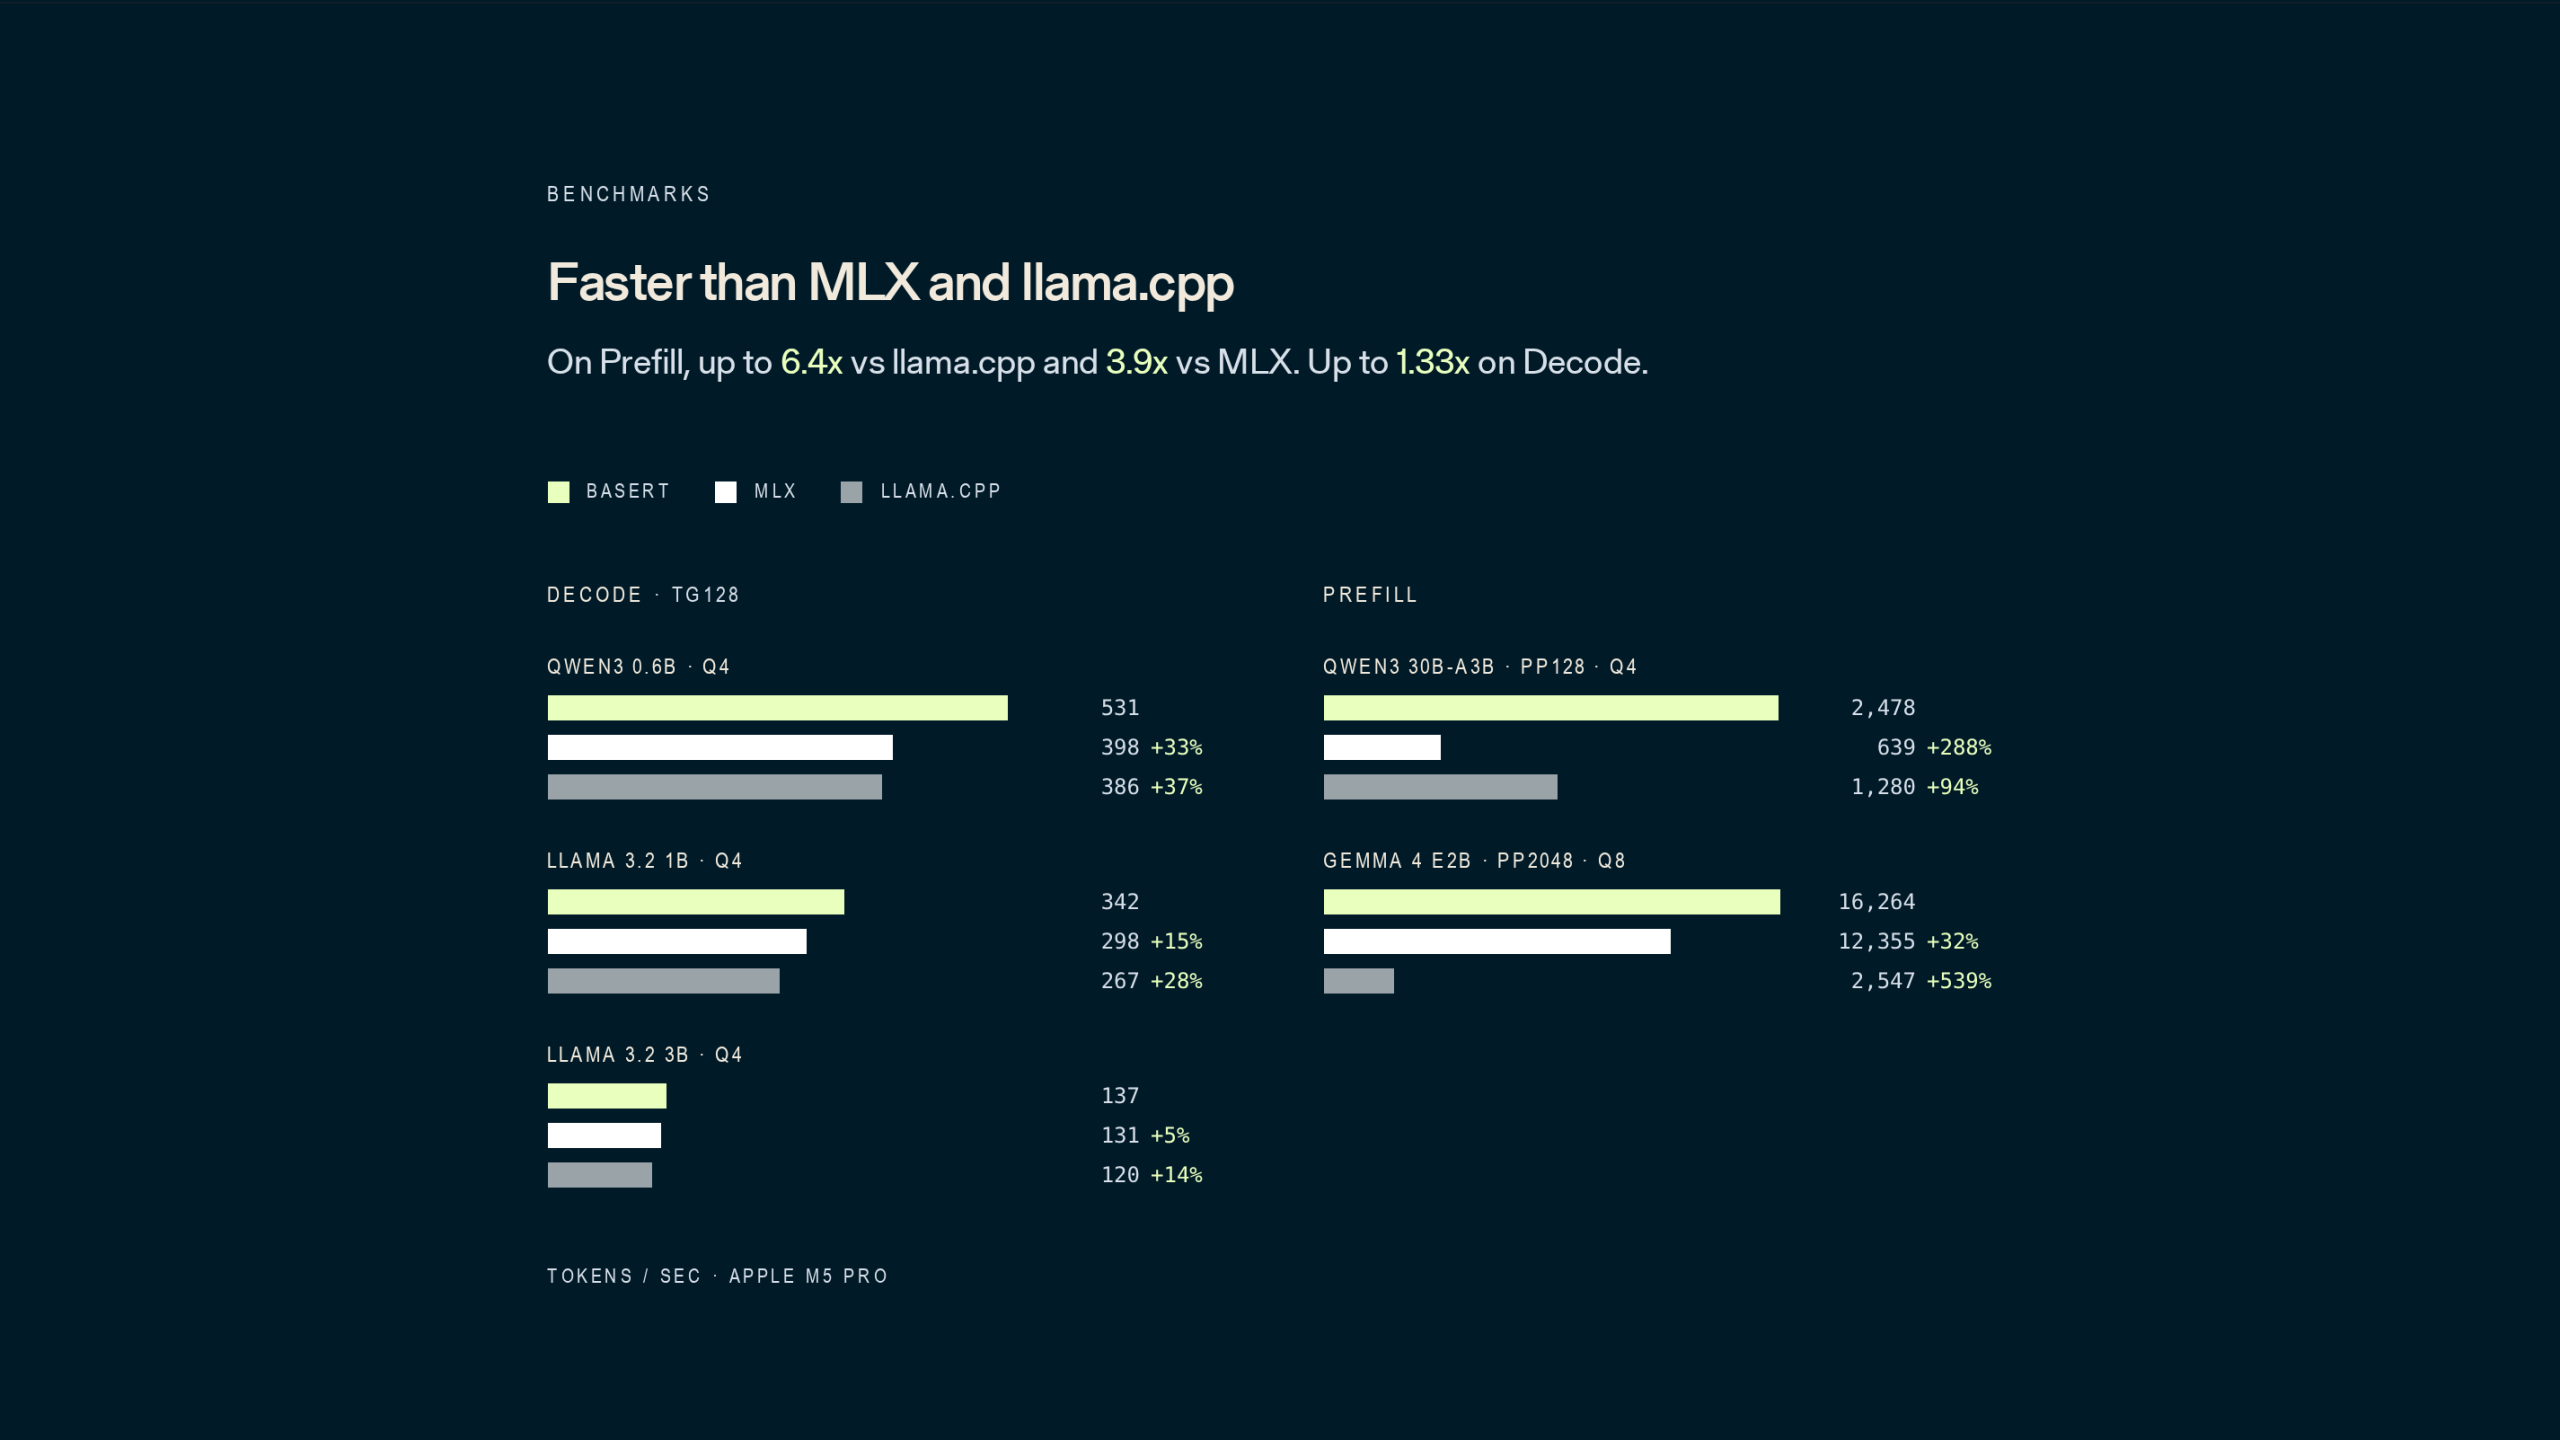
Les chiffres sont annoncés, mais ils sont sourcés. Sur un M5 Pro, la page affiche jusqu’à 6,4x llama.cpp et 3,9x MLX en prefill, jusqu’à 1,33x en decode. Le graphique détaille : sur Qwen3 30B-A3B en Q4, 2 478 tokens/s en prefill contre 1 280 pour llama.cpp et 639 pour MLX. L’écart se creuse sur les modèles à mélange d’experts, où la multiplication matricielle domine.
Là, l’équipe est crédible. Deux publications arXiv expliquent d’où vient l’écart : la génération M5 dot chaque cœur d’un accélérateur neuronal exposé via l’API tensor de Metal 4, et BaseRT y fait passer les multiplications matricielles pendant que le décodage, limité par la mémoire, reste sur ses noyaux précédents. En parallèle, des agents de recherche portent et optimisent les nouvelles architectures sans supervision — sur Nemotron 3 Nano, ils ont gagné 10,8x à 12,8x en prefill par rapport au portage initial.
Deux nuances. La licence d’abord : le dépôt est en Apache-2.0 — CLI, format .base, en-têtes C, bindings et docs — mais le moteur est un binaire précompilé propriétaire, distribué tel quel dans les releases. Vous ne compilez pas le moteur. La plateforme ensuite : M1 ou plus avec macOS 14+, ou un GB10 sous Linux en arm64. Pas de x86, pas de CUDA classique.
Mon avis est nuancé. Le format .base — un fichier unique, en-tête JSON canonique, poids alignés sur 64 KiB pour un mmap propre — est un beau travail, et les bindings Python, Node, Rust et Swift au-dessus d’une API C stable ouvrent l’outillage. Mais cela ajoute un format à mémoriser à côté de GGUF et MLX, et le projet est jeune : né en juin 2026, 223 étoiles. Pour qui veut faire tourner un modèle chez soi et le brancher sur un agent sans passer par une API cloud, l’ensemble est cohérent, et les mesures de prefill sont suffisamment argumentées pour valoir le coup d’essai.
Sources