

LIFT : vos PDF et vos scans deviennent du JSON, sur votre propre GPU
⏱️ Temps de lecture estimé : 4 minutes
https://github.com/datalab-to/lift
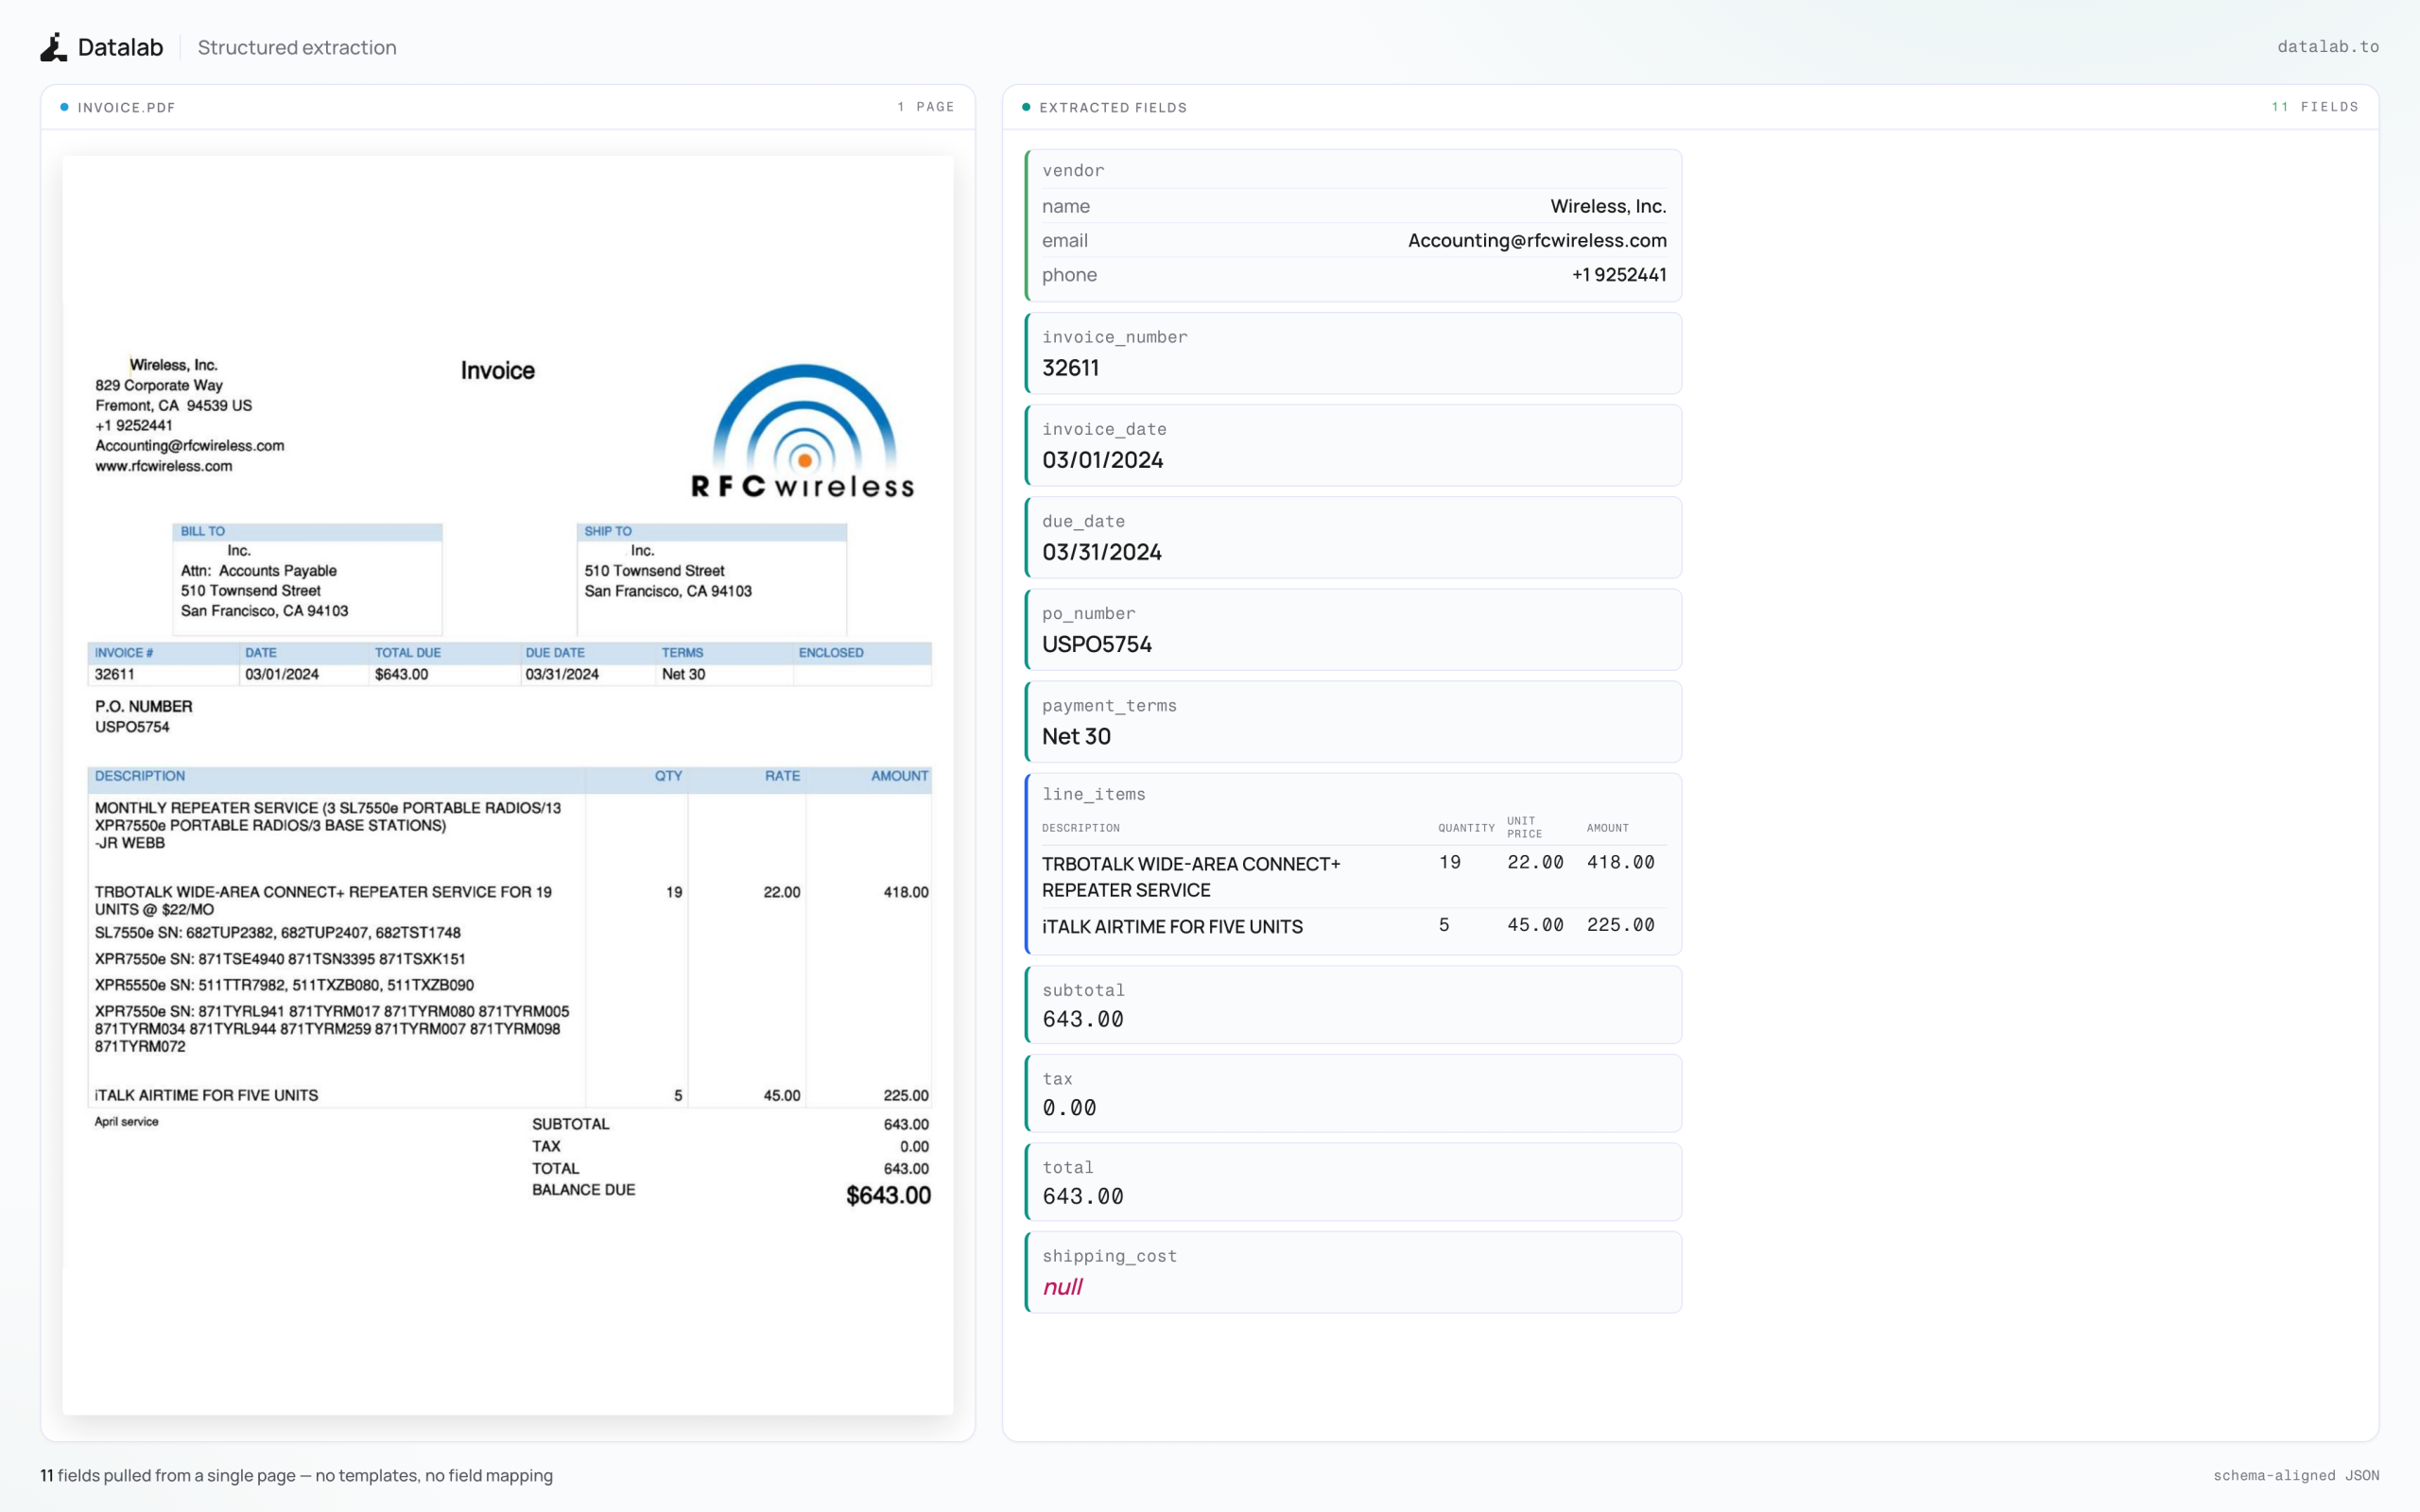
📌 LIFT est un modèle vision de 9 milliards de paramètres qui prend un PDF ou une image et renvoie un objet JSON conforme au schéma que vous lui donnez. Pas de couche OCR à caser dans le pipeline, pas de champ à espérer retrouver après coup : le décodage est contraint par le schéma, donc la sortie est valide et typée, ou elle échoue.
L’idée est simple à énoncer. Vous écrivez le JSON Schema une fois — numéro de facture, total, lignes, taux de TVA — puis vous passez un dossier entier de documents. Chaque fichier produit son .json et un _metadata.json avec le nombre de pages, les tokens consommés et, en cas d’échec, la sortie brute du modèle pour déboguer. C’est le genre de détail qui sépare un script abandonné au bout de deux semaines d’une boîte de factures qui se vide toute seule.
Sous le capot, il n’y a pas de lecture de texte : les pages sont rendues en images avec pypdfium2, puis envoyées au modèle en une seule requête, environ mille tokens par page. C’est ce qui permet à une valeur commencée page 3 et terminée page 7 de ressortir correctement, et aussi ce qui borne la longueur : un PDF de 60 pages représente déjà 50 000 tokens d’un coup.
Conséquence directe, le schéma devient le vrai sujet. Types simples, tableaux, objets imbriqués : tout passe. enum, anyOf, oneOf, $ref et additionalProperties sont écartés, parce que le décodeur saute les schémas qu’il ne sait pas compiler et que la garantie de sortie valide s’effondre. Une description sur chaque champ au nom douteux améliore la précision, required ne sert que pour ce qui doit apparaître — un champ absent du document revient null, plus exploitable qu’une chaîne vide.
Il y a deux moteurs. --method hf charge les poids dans le processus (torch, environ 19 Go au premier téléchargement), pratique pour un poste unique. --method vllm vise un serveur : lift_vllm démarre un conteneur Docker avec des réglages calculés sur la VRAM de votre carte, de la T4 à la H100, et une fenêtre de contexte de 131 072 tokens. VLLM_API_BASE pointe vers un serveur distant, et from lift import extract permet d’intégrer l’extraction à un vrai pipeline Python. lift_app ouvre Schema Studio, une app Streamlit pour construire et tester vos schémas sur vos propres documents.
Sur le benchmark publié — 225 documents de 6 à 64 pages, environ 11 000 champs notés, correspondance exacte — lift affiche 90,2 % de précision par champ et 9,5 s de latence médiane, devant NuExtract3 (81,5 %) et Qwen3.5-9B (76,3 %).
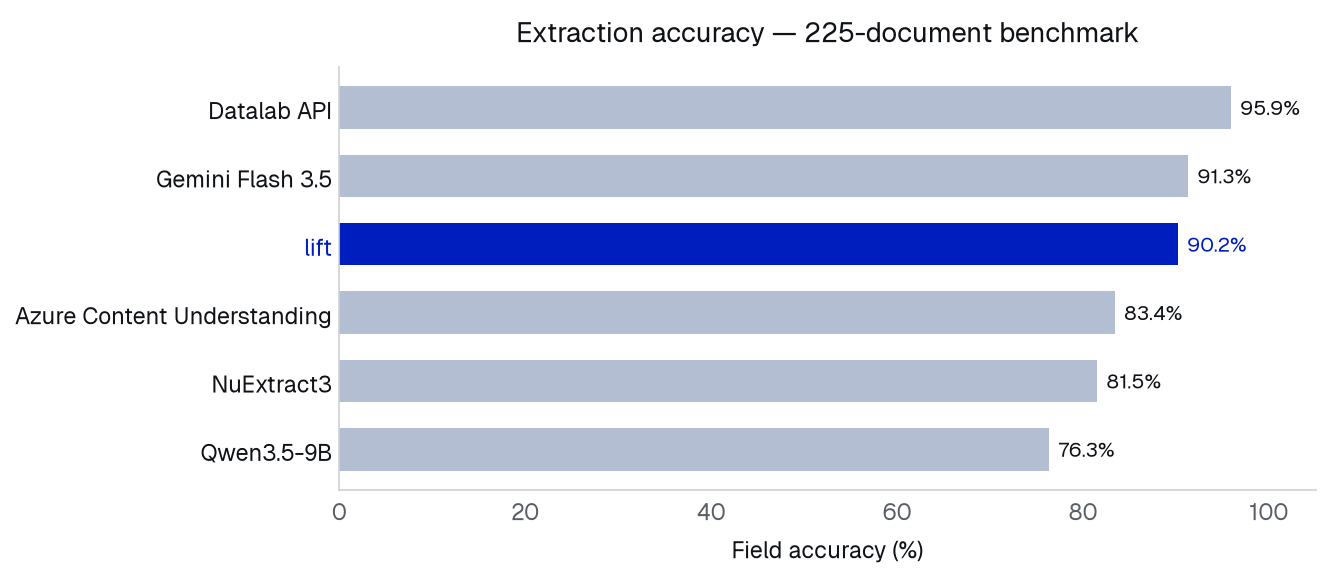
Le chiffre à regarder de près est l’autre : 20,9 % de documents entièrement corrects. Excellent champ par champ, imparfait dès qu’un document contient soixante champs et qu’un seul se trompe. L’API hébergée de Datalab annonce de son côté 95,9 % et 44,4 %, avec vérification par champ, citations et scores de confiance.
Mon avis : c’est le meilleur rapport entre ce que vous récupérez et ce que vous divulguez à un tiers. Vos contrats, vos relevés et vos dossiers clients ne quittent pas la machine, et le code est en Apache 2.0. Réserve réelle sur les poids, qui relèvent d’un OpenRAIL-M modifié : recherche, usage personnel et startups sous 5 M$ de financement, interdit en concurrence directe avec leur API, licence commerciale à part. À savoir avant de bâtir une chaîne de production dessus. Enfin, la version 0.1.1 date de juin et demande Python 3.12 ou plus.
- 📄 Un fichier, un dossier complet ou une plage de pages en une commande
- 🎯 Le schéma contraint la génération : du JSON valide, ou une erreur franche
- 🔒 Les documents ne quittent pas la machine, code en Apache 2.0
- 🛠 Schema Studio en Streamlit pour ajuster un schéma sur vos vrais documents
- ⚖️ 90,2 % de précision par champ, 20,9 % de documents entièrement corrects
Sources