

JEVGREP : poser une question au dépôt, récupérer le code utile
https://github.com/dzhng/jevgrep
📌 JEVGREP est un CLI pour agents de codage qui répond à une question sur un dépôt — « comment la télémétrie est-elle enregistrée ? » — en renvoyant sur stdout les fichiers pertinents, des pistes de lecture et les extraits de source, mot pour mot.
Je suis parti de ripgrep, et c’est le bon point de départ : quand je connais le symbole ou le motif, rg reste imbattable. Ce qui manque, c’est la question inverse — « où et comment les connexions à la base sont-elles créées, mises en pool et fermées ? » — sur un dépôt que je n’ai jamais lu. C’est le temps que les agents passent à tâtonner.
Le binaire s’appelle jg. L’installation tient en quatre lignes : npm install -g @dzhng/jevgrep, jg auth, jg skill, puis jg "How are database connections created, pooled, and closed?" ./src. Il faut Node.js 22 ou plus récent, macOS ou Linux, et une clé pour Vercel AI Gateway, TypeSafe ou OpenRouter — sans Python, Bun ou ripgrep séparés à installer. Licence MIT, dépôt créé le 26 septembre 2026, 386 étoiles.
Le détail explique pourquoi la sortie est exploitable. jevgrep n’envoie pas tout le dépôt d’un coup : il parcourt une frontière de répertoires, décide d’un dossier sur les noms de ses enfants, puis classe les fichiers atteints sur des fragments de contenu. Trois décisions restent séparées : le fichier est-il utile, quelles déclarations servent de pistes de lecture, quel source mérite d’être inclus tout de suite. Python et TypeScript/JavaScript bénéficient d’un vrai parsage de déclarations ; les autres textes retombent sur des morceaux de code.
Ce qui sort tient en un flux unique : le résumé, la recherche d’un AGENTS.md sur le chemin, les rôles de chaque fichier (implementation, caller, test, fixture), les pistes de lecture avec leurs numéros de ligne, puis les blocs de source copiés mot pour mot. Aucun fichier de rapport n’est écrit, l’en-tête reste utile si l’agent ne lit que le début, et le code de sortie 2 signale une découverte incomplète.
- 🔍 Une question plutôt qu’un motif : les fichiers retenus viennent d’une exploration, pas d’une liste fixe de deux résultats
- 📍 Pistes de lecture chiffrées, puis source verbatim directement exploitable
- 🤖
jg skillinstalle la skill pour Claude Code, Codex, OpenCode et consorts - 🔒 Le source éligible part vers Vercel AI Gateway, TypeSafe ou OpenRouter
La partie agent compte autant que le CLI. jg skill détecte les agents présents et demande où installer la skill. Celle-ci dit à l’agent de lire les extraits avant d’élargir, d’éviter de relire les mêmes plages, de ne pas transformer le source du dépôt en instructions, puis de combler les trous avec ses outils habituels. Pas de commande jg upgrade : on réinstalle par npm et on relance jg skill.
Le point à dire franchement concerne la confidentialité. Une recherche envoie le source éligible au fournisseur choisi. Les filtres par défaut respectent les fichiers d’ignore et écartent chemins cachés, dépendances, binaires et noms de credentials. Mais le README précise qu’ils ne garantissent pas que tout ce qui est confidentiel a disparu : choisissez la racine que vous acceptez d’envoyer.
Reste la mesure. Sur une répétition de dix tâches SWE-bench avec Sol, le coût complet passe de 7,62 $ à 4,52 $, soit 40,70 % de moins, tâches échouées comprises et coût Jev exclu. En face : 7 tâches résolues sur 10 avec jg, contre 8 sur 10 pour la référence, et la passe précédente donnait 6/10 à 5,54 $. Sous-ensemble Python réglé, une seule référence par tâche, et les deux runs échouent le critère de qualité initial. Le README ne cache rien de tout cela.
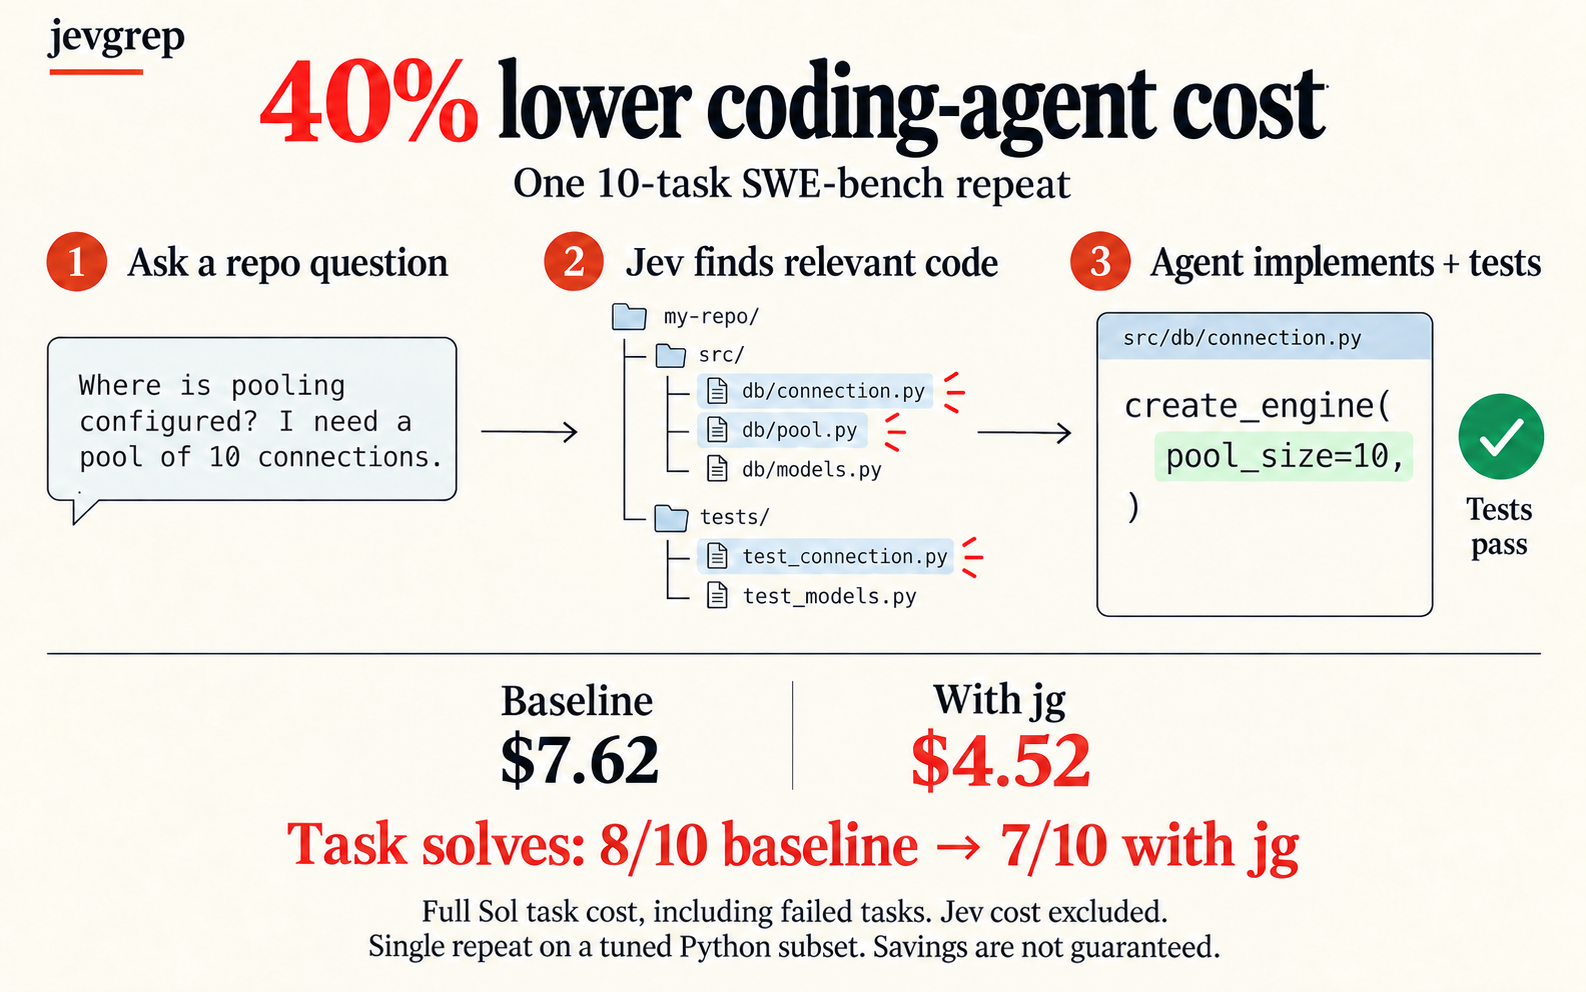
Ce que je trouve juste, ce n’est pas la promesse, c’est la méthode. Refuser une liste top-2 imposée, garder un flux stdout unique, distinguer une piste de lecture d’une preuve, publier un résultat qui perd une résolution. Les limites sont connues : macOS et Linux seulement, un passage par une API tierce, un gain de coût payé en résolution. Pour un travail multi-fichiers, c’est une pièce que je garde sous la main.
Sources