

HEDOS : une seule étagère pour tous vos modèles IA locaux
⏱️ Temps de lecture estimé : 4 minutes
📌 HEDOS est un binaire Rust qui inventorie les modèles IA déjà présents sur votre machine — Ollama, cache Hugging Face, GGUF en vrac — puis les sert via un gateway local compatible OpenAI, Ollama et Anthropic. Une TUI pour tout gérer, du chat à l’image. MIT, gratuit, hors ligne.
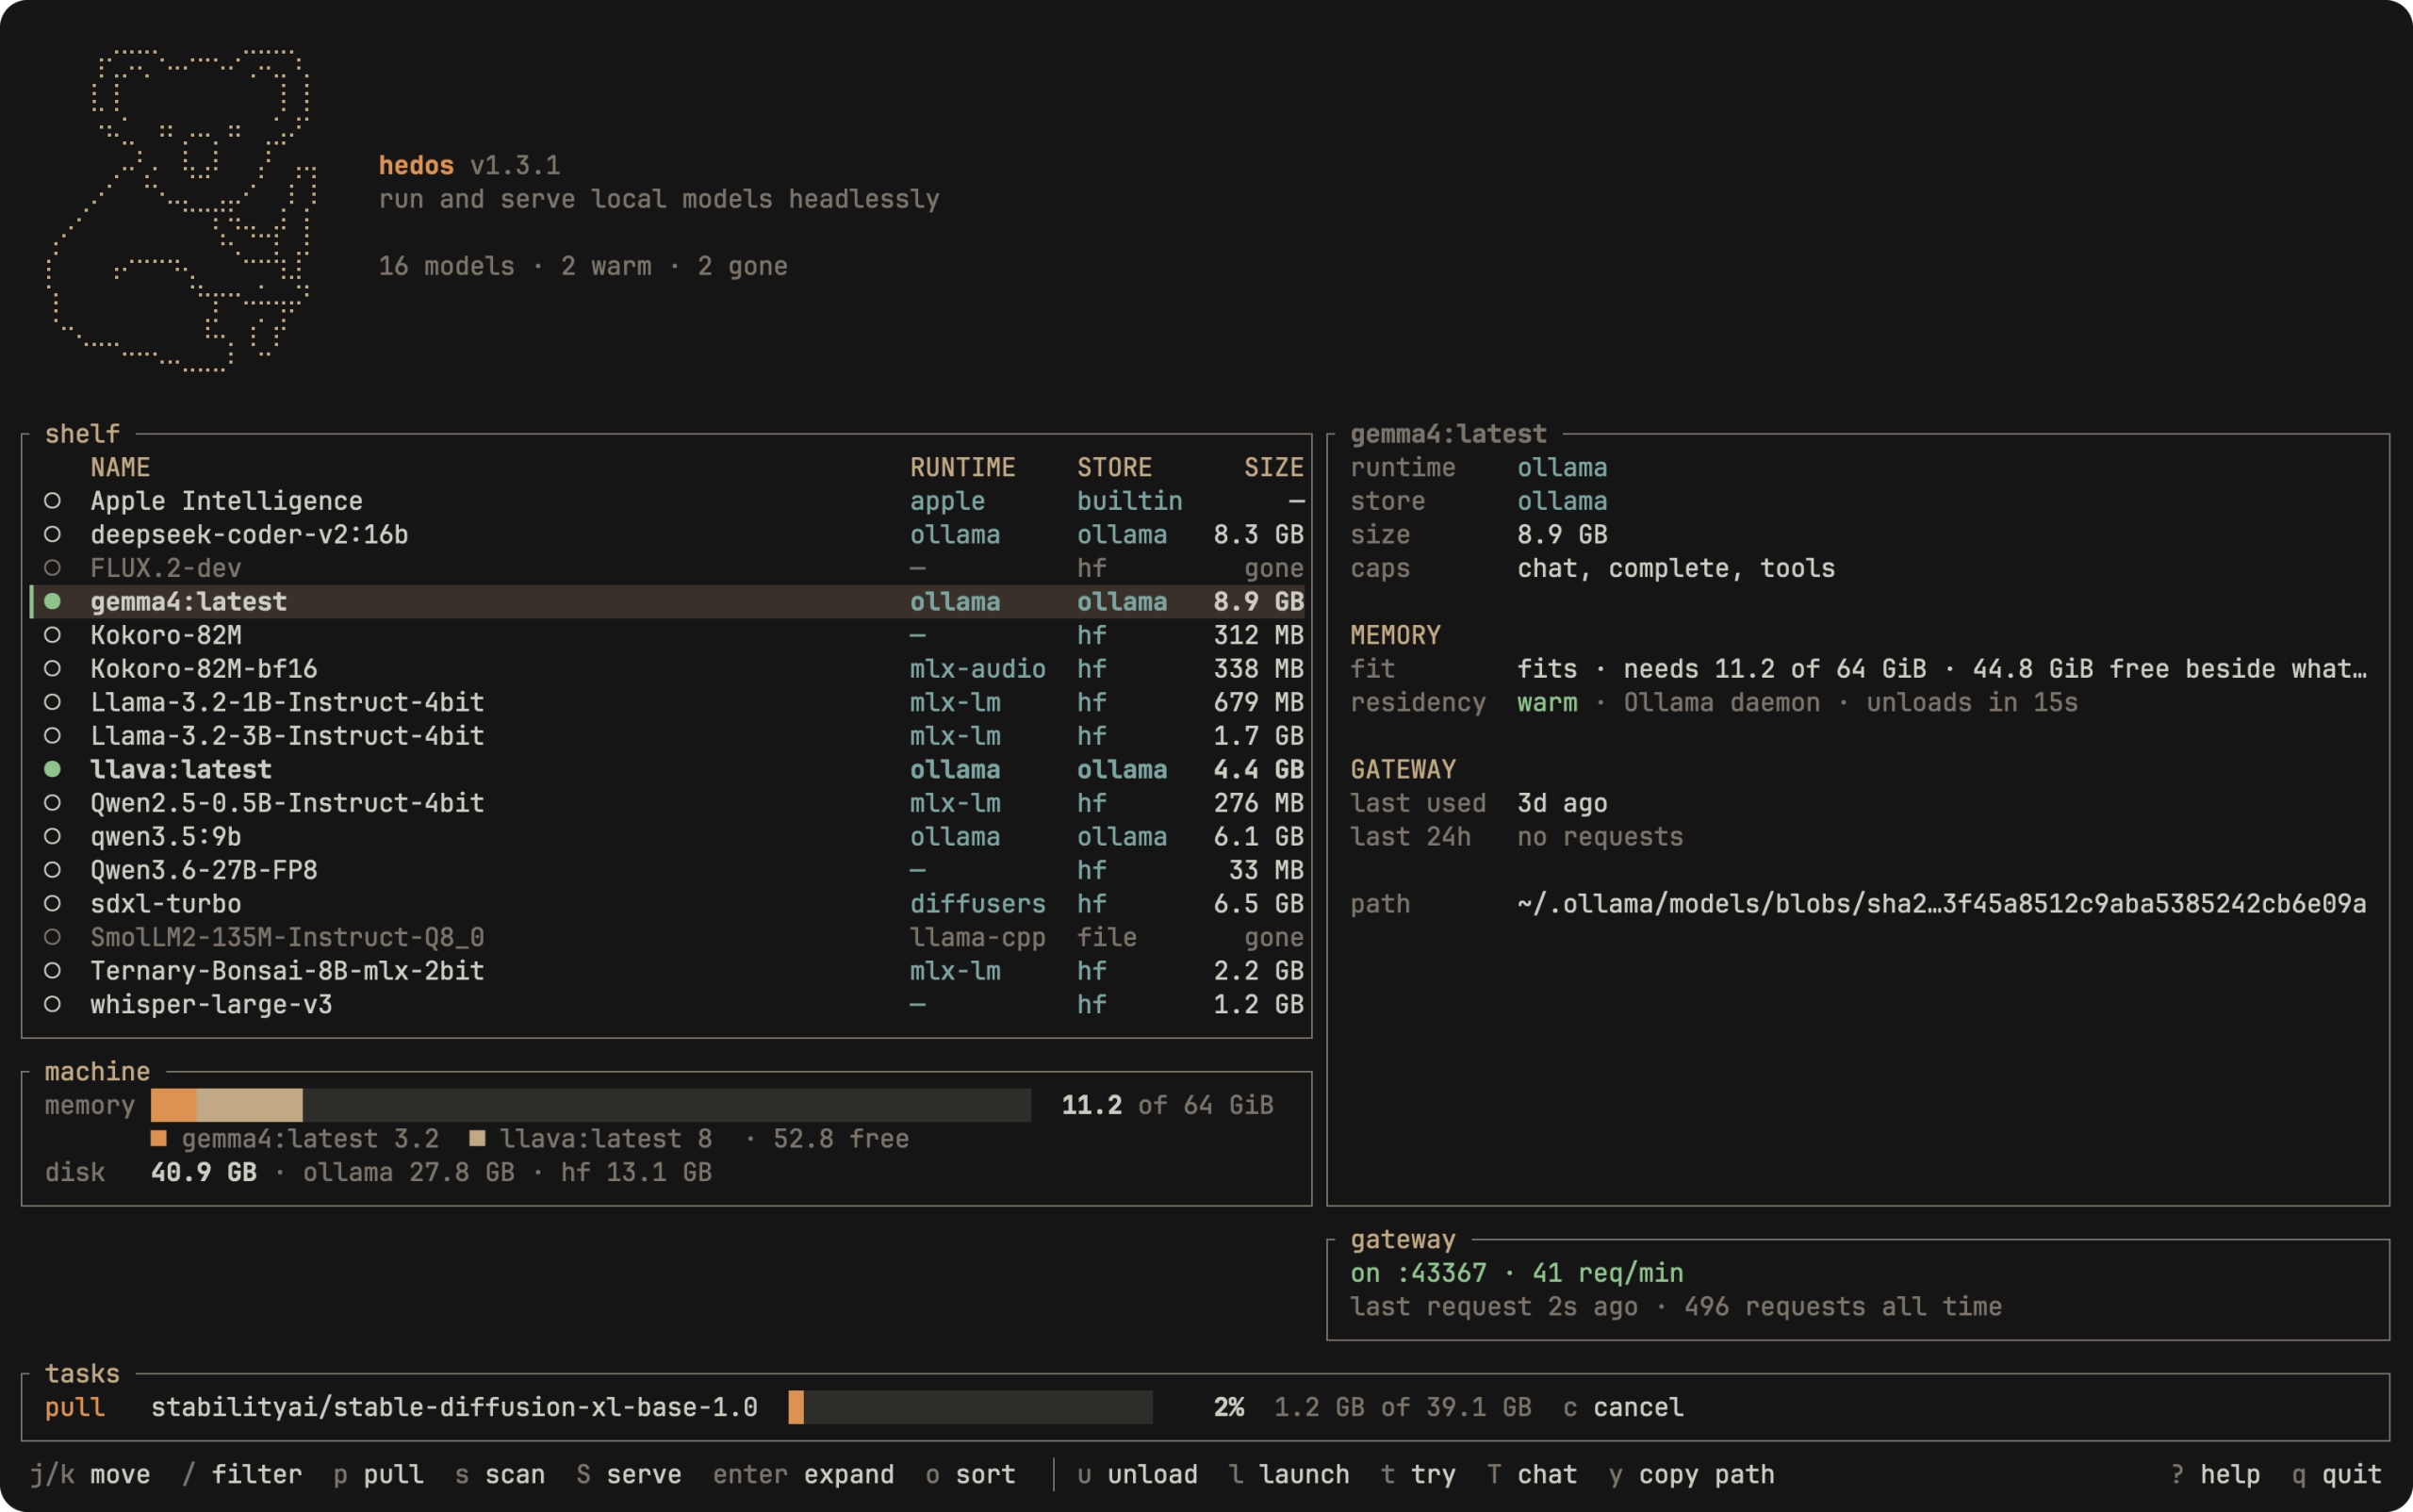
Le nom est un programme : ἕδος, en grec, l’endroit où une chose vient se reposer. Concrètement, hedos scanne les endroits où les modèles s’accumulent vraiment : le magasin d’Ollama, le cache Hugging Face, la bibliothèque de LM Studio, les fichiers GGUF et safetensors posés en vrac. Sans déplacer un octet. Chaque modèle est ensuite résolu vers le moteur qui le sert le mieux — llama-server pour un GGUF local, le daemon Ollama, un endpoint OpenAI-compatible, ou un sidecar Python pour les modèles MLX, la voix, la transcription ou la génération d’image.
Le résultat se lit dans hedos shelf, une TUI qui garde tout sous les yeux : le modèle chargé et par qui, la barre mémoire avec un segment par modèle, ce que le gateway a servi dans la journée. Chaque touche correspond à une sous-commande — p télécharge, t ouvre une conversation avec le modèle sélectionné, l lance un agent de code. Ça marche par SSH et dans tmux.
Côté installation, hedos pull cherche dans Ollama et Hugging Face, planifie le téléchargement — fichiers, taille, destination — et demande confirmation avant de bouger le premier octet. Les poids atterrissent dans leur habitat natif, le cache hub Hugging Face standard avec reprise et vérification SHA-256. hedos ne possède aucun répertoire de poids : vos autres outils continuent de voir les modèles. Un téléchargement survit même au terminal qui l’a lancé.
Le morceau que je trouve le plus malin : hedos launch. Il assoit Claude Code, OpenCode, Aider, Goose ou Crush sur un modèle de l’étagère. Un gateway démarre dans le même processus sur un port libre, le harness est branché dessus, et les deux s’arrêtent ensemble. Votre config d’agent n’est jamais touchée. Avant de lancer quoi que ce soit, hedos envoie une requête test : un modèle sans tool calling est écarté avec une raison claire, pas une erreur mystérieuse au milieu d’une session.
Pour le reste, hedos serve expose un endpoint unique sur 127.0.0.1 dans les formats OpenAI, Ollama et Anthropic — un éditeur, un script ou un agent pointe dessus et atteint toute l’étagère. Les verbes couvrent tous les sens : run pour le texte, --image pour la vision, speak pour la synthèse vocale en WAV, transcribe avec whisper, image pour générer un PNG en local. Et chaque commande parle JSON sur demande.
Deux nuances honnêtes. Le gateway fait confiance à tout appelant local et ne demande pas de token : gardez-le sur loopback. Et le projet reste jeune — 43 étoiles sur GitHub, macOS et Linux seulement, sans version Windows.
Je trouve l’approche juste : hedos ne remplace rien et ne déplace rien, il met des noms sur ce que votre disque contient déjà et rend chaque modèle appelable de la même façon. C’est exactement le chaînon entre « j’ai téléchargé des modèles » et « je les utilise ».
- 🗄️ Découvre les modèles d’Ollama, Hugging Face, LM Studio et les GGUF en vrac, sans rien déplacer
- 🖥️
hedos shelf: TUI complète avec mémoire, gateway et tâches, utilisable par SSH et tmux - 🚀
hedos launchassoit Claude Code, OpenCode, Aider, Goose ou Crush sur un modèle local - 🔀 Gateway loopback unique qui parle OpenAI, Ollama et Anthropic, tool calls compris
- 👁️ Texte, vision, parole, transcription et image : un verbe par sens
- 🆓 MIT, Rust, macOS et Linux, un seul binaire
Sources