

DOCJEV : classer et découper des paquets de PDF en millisecondes
⏱️ Temps de lecture estimé : 3 minutes
https://github.com/jerryjliu/docjev
📌 DOCJEV est une bibliothèque Python open source qui classe et découpe des documents à partir de règles rédigées en langage naturel. Donnez-lui un PDF, un DOCX ou un PPTX avec vos catégories, et Jev — le moteur de décision — prédit la catégorie du document ou les frontières entre les documents qui composent un paquet. Le tout en quelques centaines de millisecondes.
Derrière ce projet, Jerry Liu, le fondateur de LlamaIndex. Sauf que DocJev est une implémentation indépendante : elle n’appelle pas les API Classify et Split hébergées de LlamaIndex. Le pipeline combine LiteParse, un parseur Python local qui extrait le texte complet des pages, OCR compris, et Jev, un service hébergé qui prend les décisions. LlamaParse n’intervient qu’en option, pour l’OCR cloud des scans difficiles, avec trois niveaux de qualité.
Les règles tiennent dans un fichier YAML : un identifiant stable et une description de la fonction du document. « Une facture est une demande de paiement pour des biens déjà fournis. » Vous décrivez l’intention, le moteur déduit. La catégorie other est ajoutée automatiquement si vous l’oubliez.
Trois façons de s’en servir : le CLI (docjev classify, docjev split, sortie JSONL pour un dossier entier), l’API Python avec ses versions asynchrones, et une petite app locale lancée par uv run docjev demo sur localhost:8765. Éditez vos catégories, lancez la classification en direct, téléchargez les PDF découpés. La page /race va plus loin : elle fait courir Jev et GPT-5.6 Luna côte à côte sur le même texte, temps de décision affichés.
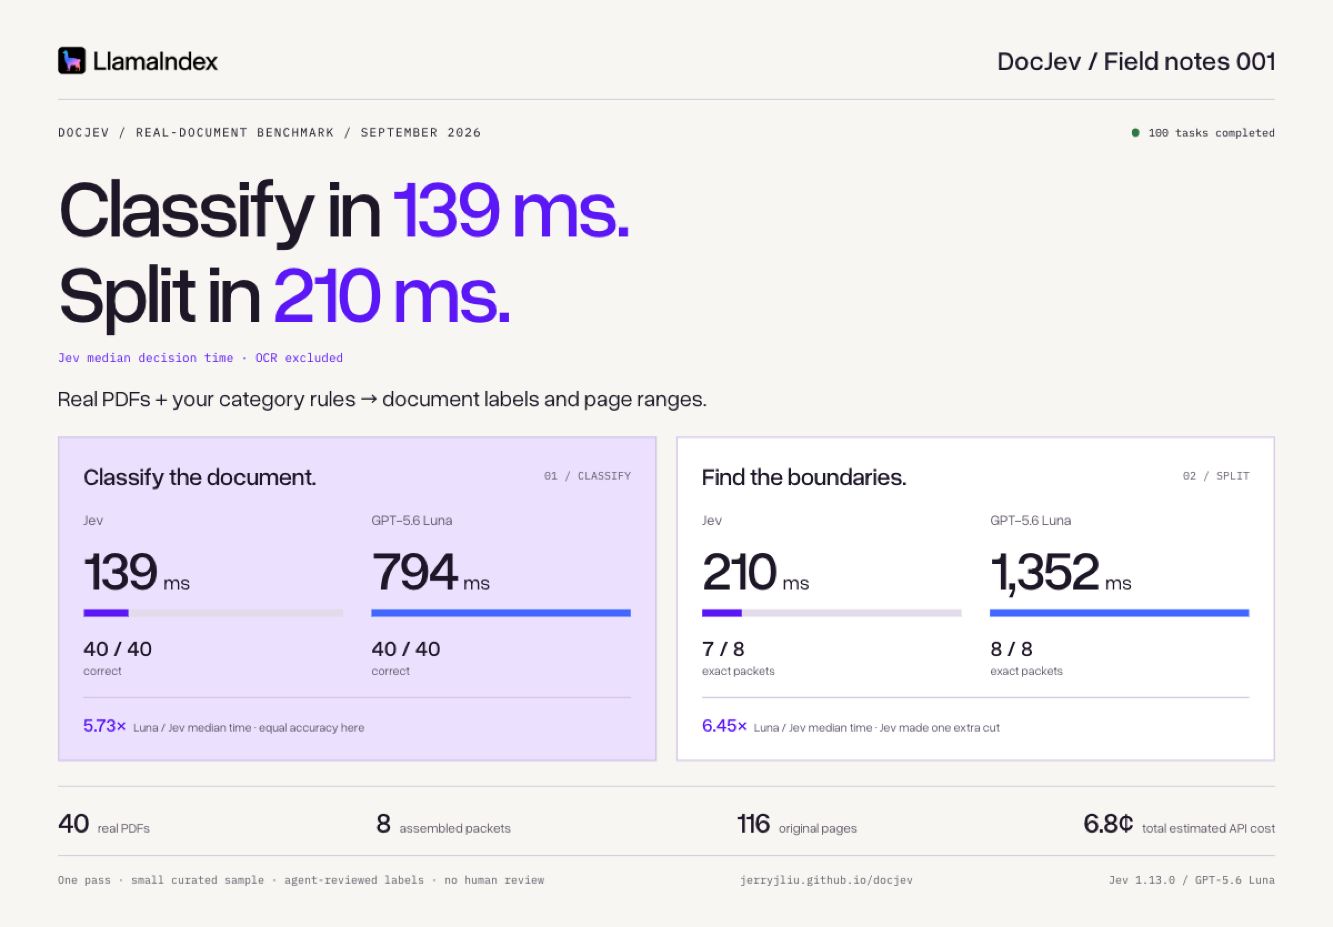
Je trouve le benchmark rafraîchissant par son honnêteté : 40 vrais PDF publics (IRS, Treasury, BEA, SEC), huit paquets de cinq documents, une seule passe, protocole complet publié. Jev classe 40/40 et découpe 7/8 paquets exactement, Luna 40/40 et 8/8. Mais Jev tranche en 138,6 ms en médiane contre 794 ms pour Luna — 5,7 fois plus vite — pour un coût de décision d’environ un centime contre cinq. Et l’extraction locale, elle, ne coûte aucun frais d’API.
Points clés de DocJev :
- 📄 Classify : un document, une catégorie, des probabilités et des signaux de relecture
- ✂️ Split : des segments ordonnés avec plages de pages et export PDF par document
- 🌐 Extraction locale avec LiteParse, OCR cloud LlamaParse en option
- 🖥️ App locale sur localhost:8765, clés conservées sur votre machine
- ⚡ Décisions en ~140 ms, environ 6× plus rapide que GPT-5.6 Luna sur le même protocole
Les limites sont explicites : le découpage reste au niveau de la page, Jev est un service hébergé donc l’inférence n’est pas hors ligne, et il faut une clé API TypeSafe, plus LibreOffice pour les DOCX et PPTX. Le paquet mal découpé l’a d’ailleurs été sur une pièce jointe de communiqué de la Fed — avec un score de frontière proche du seuil, signalé pour relecture plutôt que masqué. Cette transparence est rare.
Si vous noyez sous des paquets de PDF — comptabilité, juridique, compliance — c’est un outil à essayer ce week-end.
Sources