

VOXCPM2 : le TTS open source qui clone une voix et vous laisse diriger
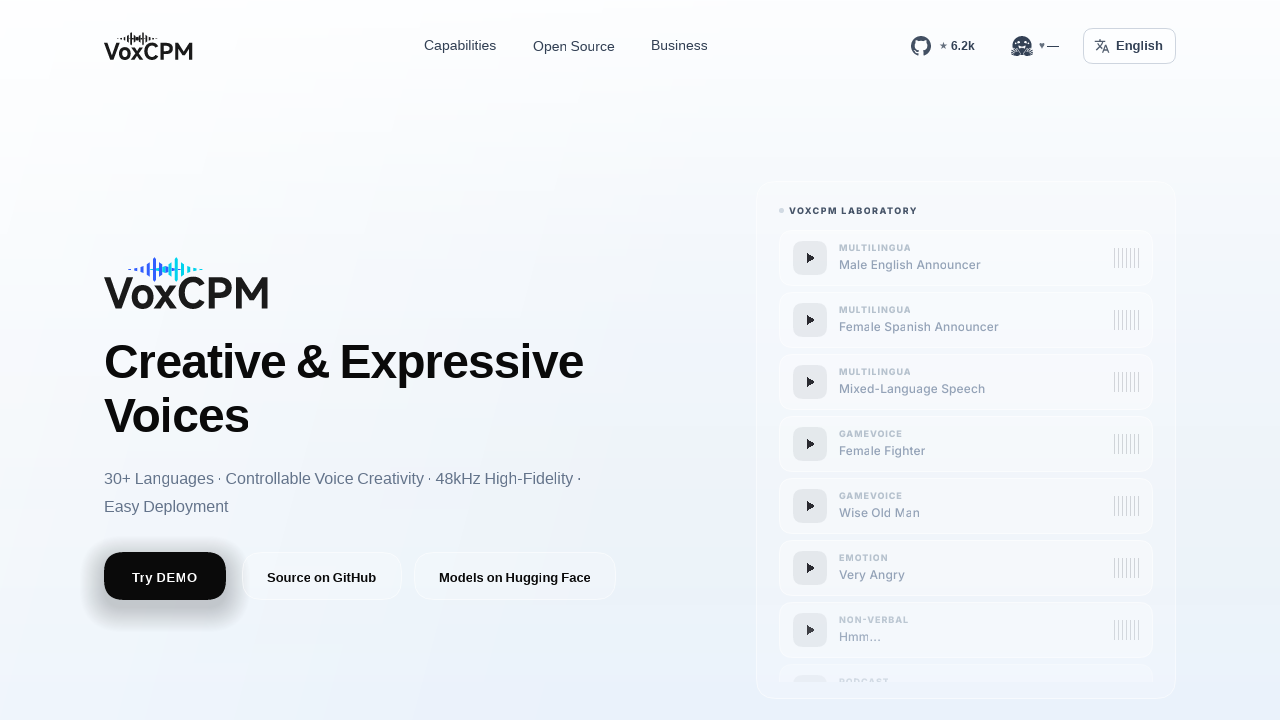
📌 VOXCPM2 est un modèle de synthèse vocale open source signé OpenBMB : 2 milliards de paramètres entraînés sur plus de 2 millions d’heures de parole, 30 langues dont le français, sortie 48 kHz, et un clonage de voix décliné en trois modes.
Techniquement, VoxCPM2 fait partie des TTS « tokenizer-free » : plutôt que de découper la parole en tokens discrets, une architecture diffusion autorégressive génère directement des représentations continues dans l’espace latent d’AudioVAE V2. Résultat annoncé par les benchmarks : une expressivité au-dessus du lot, et une sortie en 48 kHz studio même quand votre échantillon de référence n’est qu’en 16 kHz — la super-résolution est intégrée.
Le cœur du sujet, c’est le clonage, et il existe à trois niveaux. Le clonage « ultime » fournit l’audio de référence et sa transcription : le modèle poursuit la phrase comme si le locuteur continuait de parler, avec le timbre, le rythme et l’émotion d’origine. Le clonage « contrôlable » se contente d’un court extrait, mais ajoute une instruction entre parenthèses — « légèrement plus rapide, ton joyeux » — pour diriger le jeu tout en gardant la voix. Et le Voice Design invente une voix à partir d’une simple description : une voix de jeune femme douce, un vieil homme posé, sans aucun échantillon.
Ce deuxième mode me semble être le plus intéressant pour qui crée du contenu. On ne remplace plus une voix, on la dirige : l’identité sonore reste la vôtre, la performance se règle au texte. C’est un changement de posture — moins du copiage, plus de la direction artistique.
- 🎙️ Clonage ultime — audio + transcription, chaque nuance vocale reproduite
- 🎛️ Clonage contrôlable — le timbre reste, l’émotion et le débit se pilotent
- 🎨 Voice Design — une voix inventée depuis une description en langage naturel
- 🌍 30 langues — français inclus, sans tag de langue à préciser
- 🔊 48 kHz natif — super-résolution intégrée depuis une référence 16 kHz
- 🏠 Tourne en local — GGUF via llama.cpp-omni sur CPU, Metal et CUDA
L’exécution est étonnamment accessible. pip install voxcpm suffit pour tester, avec un RTF d’environ 0,3 sur RTX 4090 — plus vite que le temps réel — qui descend à 0,13 avec Nano-vLLM. Sur Mac, les poids GGUF tournent via llama.cpp-omni sur Apple Silicon. Pour la production, vLLM-Omni expose un endpoint compatible avec l’API OpenAI. Et si une voix vous manque, le fine-tuning LoRA s’amorce avec cinq à dix minutes d’audio. Comptez environ 8 Go de VRAM.
Les nuances à connaître : le contrôle de style peut varier d’une génération à l’autre — l’équipe conseille d’essayer une à trois fois — et la licence interdit explicitement l’usurpation d’identité, la fraude et la désinformation, avec une recommandation de marquer les contenus générés. Le projet est sous Apache-2.0, donc utilisable commercialement, avec 6,2k étoiles sur GitHub et près de 400 000 téléchargements par mois sur Hugging Face.
Pour une voix de narration maison, sans abonnement et sans cloud, VOXCPM2 est le point d’entrée le plus sérieux du moment.
Sources