

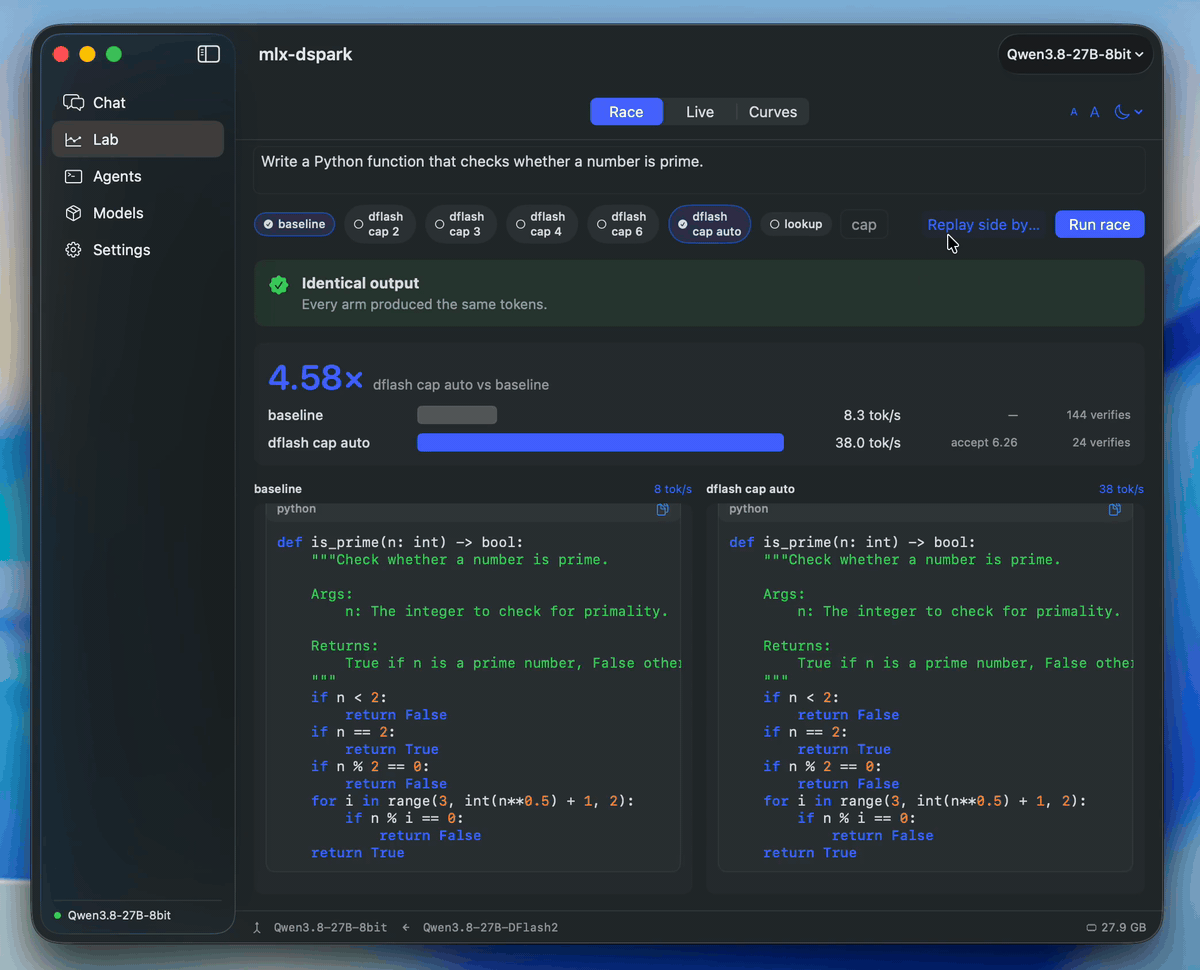
MLX-DSPARK : doublé la vitesse de vos modèles locaux
https://github.com/ARahim3/mlx-dspark
📌 MLX-DSPARK fait tourner les drafteurs de décodage spéculatif DSpark (DeepSeek) et DFlash (z-lab) nativement sur Apple Silicon via MLX. Résultat : le même texte, identique au détail près, mais jusqu’à 2 à 4 fois plus vite. 631 étoiles, MIT.
Le principe est remarquable parce qu’il est honnête. Un modèle « drafter » propose un bloc de tokens, le modèle cible les vérifie tous, et n’accepte que ceux qui sont corrects. Rien n’est inventé : si le drafter se trompe, le modèle cible corrige. La sortie est donc strictement identique à un décodage normal — seulement plus rapide. C’est une accélération sans perte, pas une approximation.
Pour qui c’est fait : les utilisateurs de Mac qui font tourner des LLM locaux via LM Studio, Ollama ou Claude Code. Le drafter et la cible sont des modèles « consumer-size » (Qwen3, Gemma-4, Muse-Glimmer, Ornith, LFM2.5, Nemotron, Bonsai), pas le DeepSeek-V4 d’origine. C’est un point que le README précise avec soin : ce n’est pas l’inférence de V4, c’est sa méthode de décodage appliquée à des modèles plus petits.
Les benchmarks sur un M4 Pro parlent clair. Gemma-4 12B passe de ~18 à ~49 tokens/s (2,78×). Ornith-1.0-9B atteint 64 tok/s (2,4×). Le plus spectaculaire : LFM2.5-1.2B monte à 333 tok/s (3,3×). Sur du code et des maths — contenu structuré qui s’accepte bien — on dépasse souvent les 3×.
Le point fort, c’est l’auto-étalonnage. Pas besoin de régler la longueur du brouillon à la main : la première fois, mlx-dspark mesure les courbes de coût de votre machine (~5 s, mis en cache) et en déduit sa propre valeur optimale. Un M1 et un M5 n’obtiennent pas le même résultat — c’est dérivé de votre matériel, pas d’une config copiée-collée.
L’intégration est large. Une API compatible OpenAI et Anthropic sur le même port — donc Claude Code peut tourner sur un modèle local, et pi aussi. Un serveur de batching continu, un cache de préfixe, et un support des agents via les Messages API et Responses API. Le binaire sert aussi en macOS natif par Homebrew.
Limites à connaître : c’est Apple Silicon uniquement (MLX), Python ≥ 3.10. En dessous de ~4B, un drafter ne vaut pas la peine — le modèle cible est déjà tellement rapide que la passe de brouillon ne compense plus. Et sur les très petits tokens quantifiés 2-bit comme Bonsai, le gain tombe à ~1,1×.
- ⚡ Décodage spéculatif lossless : même sortie, 2 à 4× plus vite
- 📏 Auto-étalonnage : le cap optimal est mesuré sur votre Mac, pas imposé
- 🖥️ Serveur OpenAI + Anthropic : Claude Code et pi sur modèle local
- 🔧 DSpark et DFlash sous une même boucle de vérification
- 📊 Benchmarks reproductibles :
mlx-dspark benchmark --trials 3 - 🍎 Apple Silicon uniquement, via MLX, Python ≥ 3.10
Sources