

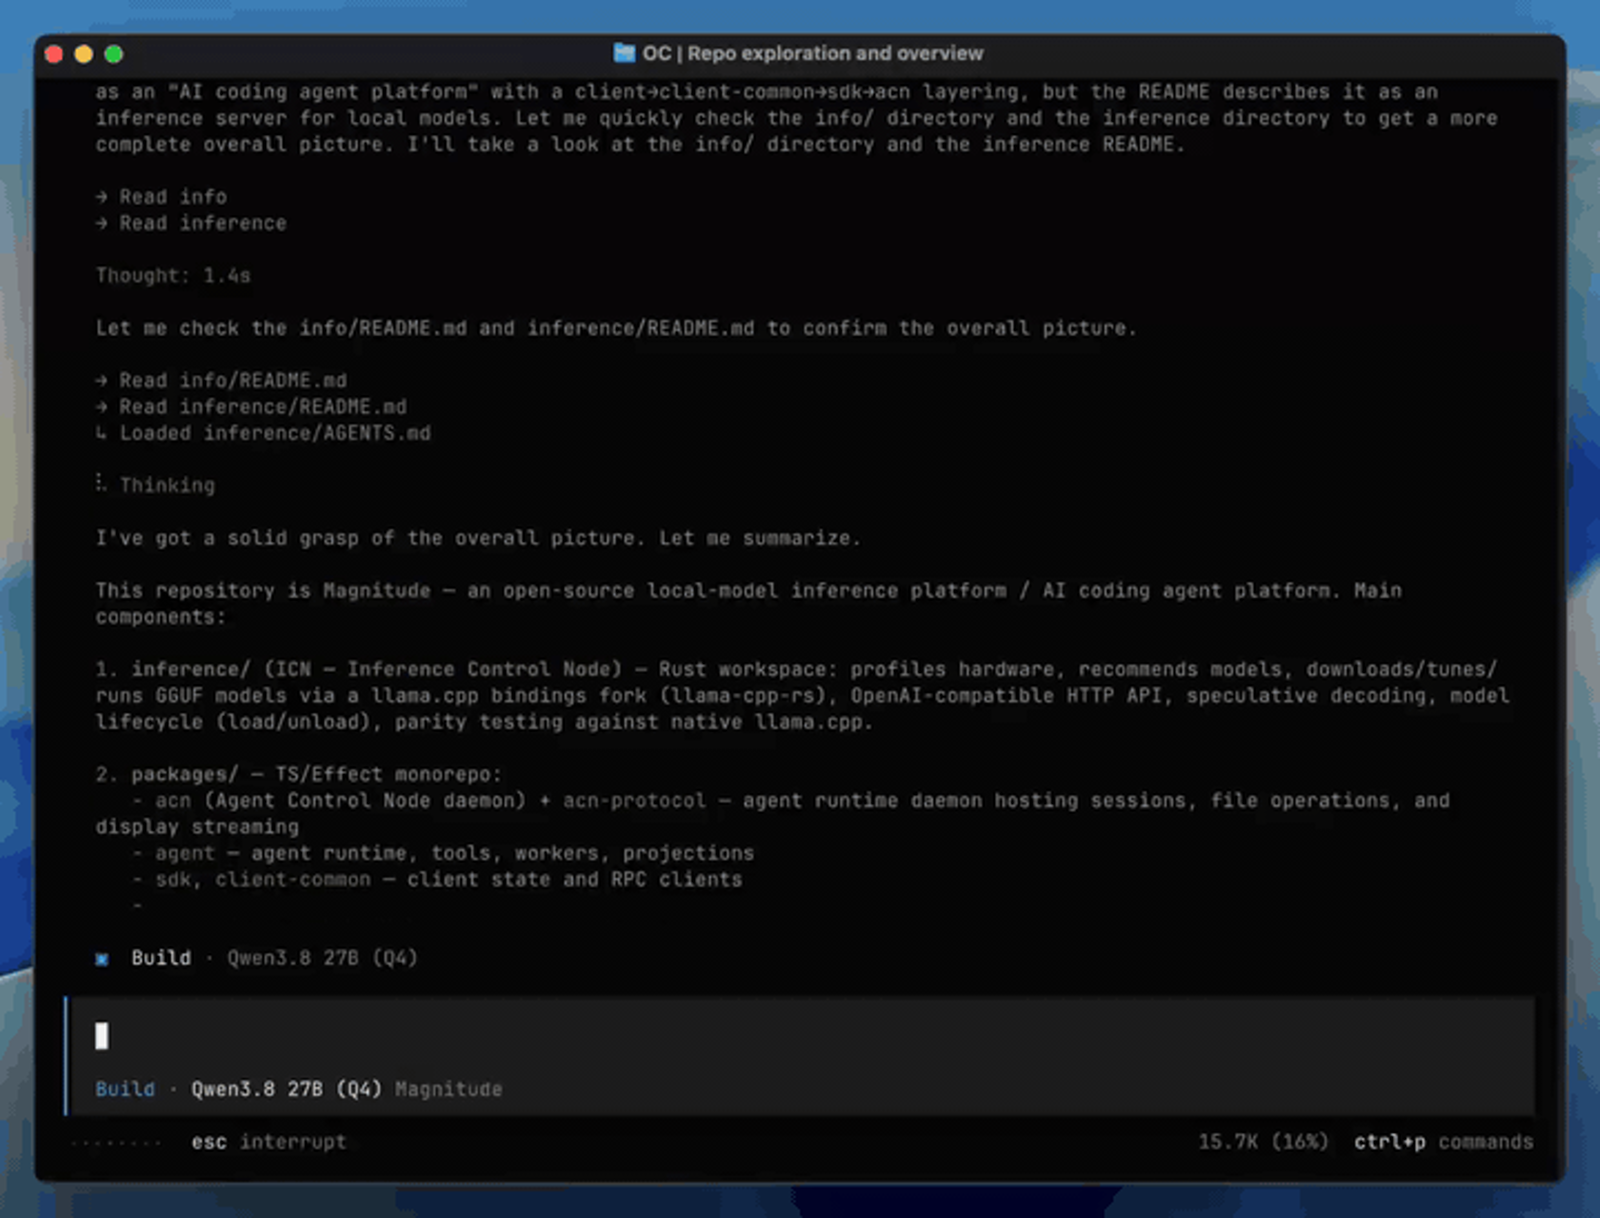
MAGNITUDE : le LLM qui tourne sur la machine que vous avez déjà
📌 MAGNITUDE est un moteur d’inférence local open source qui tourne sur le matériel que vous possédez déjà : il profile votre machine, classe les configurations compatibles, télécharge et règle le modèle choisi, puis le branche sur l’agent que vous utilisez déjà — Claude Code, Codex, OpenCode ou n’importe quel harnais du panier.
Mon premier souvenir d’inférence locale, c’est une heure de flags au hasard, un modèle qui tient de travers, et des tokens par seconde décevants. Magnitude inverse l’équation : la machine se profile elle-même, et le modèle est choisi en fonction de ce qu’elle peut réellement faire.
La boucle est pensée pour l’agent d’abord. Vous collez un prompt dans votre agent — « installe le CLI Magnitude et suis les instructions » — et c’est lui qui profile, recommande, télécharge et se reconnecte au modèle. À la main, cela se résume à npm i -g @magnitudedev/cli puis magnitude setup. Le processeur, la mémoire, la bande passante et l’architecture sont analysés, avec l’accélération disponible (Metal, CUDA). Surtout : le calibrage estime la compatibilité et la vitesse sans télécharger les poids, et il est recalculé à chaque évolution de la machine.
À partir de là, Magnitude classe jusqu’à dix configurations selon l’intelligence du modèle, la vitesse de génération estimée, la qualité de quantification, la taille de contexte et la mémoire physique. Chaque recommandation est un triplet : modèle, quantification et contexte, assorti d’une vitesse annoncée comme une fourchette — « ~36–48 tok/s ». Un curseur Fast to Smart vous laisse trancher entre vitesse et intelligence. Le prix à payer pour ce confort : une estimation, pas une promesse ; le débit réel varie avec la longueur des prompts, la charge et la révision du modèle.
Derrière, un serveur headless écrit en Rust sur llama.cpp, installé et géré par Magnitude — aucun runtime à configurer séparément. Les modèles restent sur disque dans ~/.magnitude/models et se chargent à la demande, quand l’agent envoie une requête. Inutilisés, ils se déchargent pour libérer la mémoire, sans être supprimés ni dé-sélectionnés. Le serveur re-vérifie la pression mémoire avant chaque chargement et arrête le modèle si elle devient dangereuse. Le contexte configuré est préservé — pas de réduction silencieuse pour caser plus de requêtes — et en session continue, l’état de prompt compatible est réutilisé pour éviter de re-traiter l’historique.
- 📊 Profil CPU, mémoire, bande passante, accélération Metal/CUDA
- 🏆 Jusqu’à 10 configurations classées : modèle + quantification + contexte
- ✨ Agent-first : un prompt, l’agent installe et se greffe lui-même
- 🟰 Formats normalisés (reasoning, tool-calls, templates) entre modèles
- 🪶 Chargement à la demande, déchargement au repos, mémoire protégée
- 🔌 Neuf harnais : Claude Code, Codex, OpenCode, Pi, Hermes, OpenClaw, Oh My Pi, Cline
La normalisation est le détail qui change tout : chaque modèle local parle son propre langage de raisonnement, de tool-calls et de templates. Magnitude les uniformise, si bien que vos harnais changent de modèle sans implémentation spécifique — l’argument le plus solide pour passer d’un modèle à l’autre sans casse. Le changement se fait depuis le menu déroulant du harnais, ou en demandant à l’agent de chercher un modèle plus rapide dans le catalogue. Il découvre même les GGUF hors catalogue rangés dans votre cache Hugging Face.
Une fois un modèle téléchargé, toute la chaîne fonctionne sans connexion : prompts, fichiers et modèles restent sur votre disque, sans clé API, sans facturation au token, sans limite de débit. C’est un vrai cadre pour le travail sensible, et la trajectoire est sérieuse : Apache 2.0, plus de 4 300 étoiles, équipe soutenue par Y Combinator, moteur Rust actif. Le projet est jeune, les modèles locaux n’égaleront pas les plus gros cloud sur l’intelligence pure — mais pour qui veut un LLM qui tourne sur sa machine sans trilogie de tutoriels, MAGNITUDE est l’option la plus fluide que j’ai vue. Essayez dix directions, gardez celle qui tourne.
Sources