

Flash-MoE : un modèle de 397 milliards de paramètres qui tourne sur un MacBook
https://github.com/danveloper/flash-moe
📌 FLASH-MOE est un moteur d’inférence open source écrit en C pur et Metal qui fait tourner Qwen3.5-397B-A17B, un modèle Mixture-of-Experts de 397 milliards de paramètres, sur un MacBook Pro doté de 48 Go de mémoire unifiée, à plus de 4,4 tokens par seconde, avec une qualité de sortie de niveau production et le support complet du tool calling. Le point névralgique n’est pas la puissance de calcul mais la donnée : les 209 Go de poids du modèle ne tiennent pas en mémoire, ils sont donc lus directement depuis le SSD via un pipeline Metal sur mesure. Aucun Python, aucun framework, uniquement du C, de l’Objective-C et des shaders Metal écrits à la main.
L’outil simplifie radicalement l’accès aux très grands modèles. Faire tourner un modèle de 397 milliards de paramètres exige d’ordinaire un serveur équipé de plusieurs GPU haut de gamme. Ici, tout se passe sur un ordinateur portable : l’inférence consomme environ 6 Go de RAM, les poids non-experts étant mappés en lecture seule et les tampons de calcul restant limités, ce qui laisse une large marge au système pour gérer le cache de pages. Le SSD fait le travail lourd pendant que la machine reste utilisable pour d’autres tâches, même en pleine génération.
Côté architecture, le modèle repose sur 60 couches de transformeurs, dont 45 couches GatedDeltaNet (attention linéaire) et 15 couches d’attention classique. Chaque couche contient 512 experts, parmi lesquels 4 seulement sont activés par token, plus un expert partagé, pour une dimension cachée de 4096. Cette structure éparse est la clé du concept : au lieu de charger l’intégralité des poids, le moteur ne lit sur le SSD que les quelques experts actifs à chaque étape, soit environ 6,75 Mo par expert.
📌 Points clés du projet :
- 🐘 Streaming des experts depuis le SSD : les poids des experts sont lus à la demande en
pread()parallèle via les GCD dispatch groups, seuls les K=4 experts actifs par couche sont chargés. - 🧠 Trust the OS : pas de cache maison, le cache de pages du système gère tout via un LRU naturel (≈ 71% de hit rate), inspiré du papier « LLM in a Flash » d’Apple.
- ⚙️ Kernel de dequant FMA : le calcul passe de
(nibble scale + bias) xàfma(nibble, scalex, biasx), soit 12% de débit en plus. - 🎛️ Shaders Metal faits main : dequant tiled matvec 4-bit/2-bit, SwiGLU fusionné, RMS normalization, attention GPU en batch, RoPE et combine/expert fusionnés.
- 🔀 Calcul GPU différé : l’expert forward est soumis sans attendre, le GPU calcule pendant que le CPU prépare la couche suivante.
- 📐 BLAS Accelerate pour l’attention linéaire :
cblas_sscal,cblas_sgemvetcblas_sgerrendent la récurrence GatedDeltaNet 64% plus rapide.
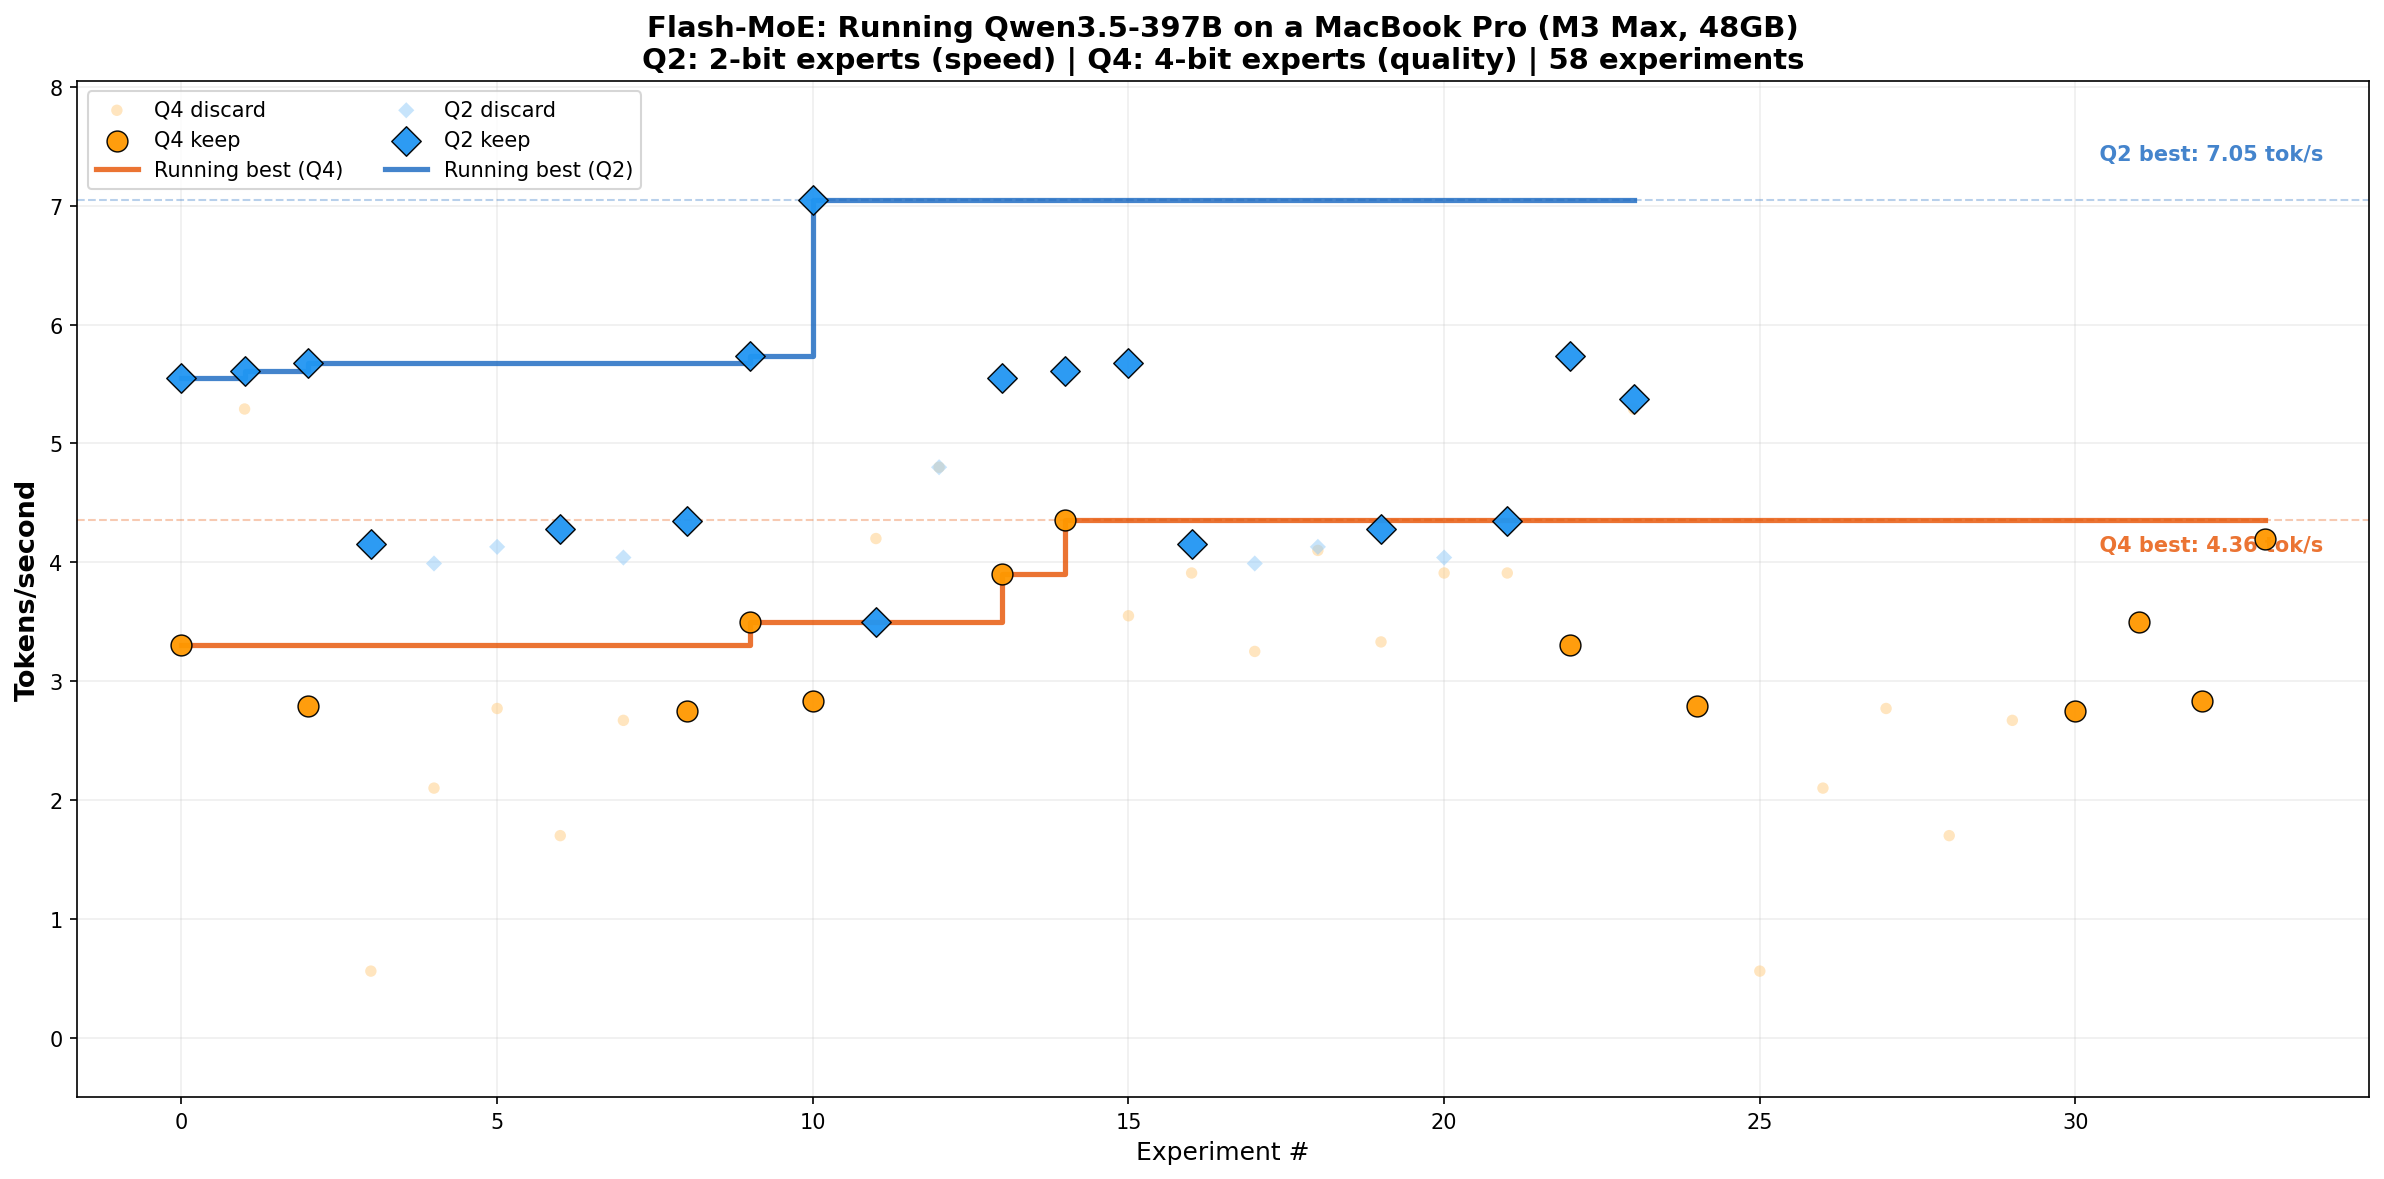
Les performances finales parlent d’elles-mêmes. En configuration de production (4-bit, kernel FMA), le moteur atteint 4,36 tokens par seconde avec un tool calling complet pour 209 Go de données sur disque ; en 2-bit, le débit grimpe à 5,74 tokens par seconde (7,05 en pic sur cache chaud) mais la quantification déforme l’échappement des guillemets dans les sorties JSON, rendant le tool calling peu fiable. C’est pourquoi le mode 2-bit est déconseillé pour un usage outillé et le mode 4-bit reste la configuration recommandée.
Le démarrage se fait en quelques commandes. Il suffit de compiler avec make dans le répertoire metal_infer, puis de lancer une inférence simple (./infer --prompt "Explique le quantum computing" --tokens 100), un chat interactif avec tool calling (./chat), ou un profiling par couche (./infer --timing). Le pipeline de chaque couche s’exécute en moyenne en 4,28 ms en 4-bit : projections d’attention et delta-net sur GPU (1,22 ms), projection o_proj et normalisation (0,55 ms), routage softmax/topK (0,003 ms), puis lecture SSD des 4 experts en parallèle (2,41 ms) et forward expert différé.
La conception s’appuie sur une contrainte matérielle bien identifiée : sur Apple Silicon, le DMA du SSD et le calcul GPU partagent le même contrôleur mémoire et ne peuvent pas être chevauchés sans perte. Les kernels de dequant saturent déjà la bande passante à environ 418 Go/s, et la moindre lecture SSD en arrière-plan provoque des pics de latence. Le pipeline série GPU → SSD → GPU est donc optimal pour ce matériel, une leçon confirmée par 58 expérimentations, dont le LZ4 (compresser les experts était 13% plus lent), le précaching F_RDADVISE (aucun gain) ou encore le mmap (5x plus lent à cause des page faults par expert).
Côté matériel, temps d’exécution et démarrage : le moteur tourne sur un MacBook Pro M3 Max (CPU 16 cœurs dont 12 performance, GPU 40 cœurs, ANE 16 cœurs) sous macOS 26.2, avec une mémoire unifiée de 48 Go et un SSD rapide capable d’environ 17,5 Go/s en lecture séquentielle. Le tokenizer BPE en C pur réduit le démarrage de 3,5 secondes à 180 millisecondes, soit un gain de 20x. Le modèle complet occupe 209 Go sur disque en 4-bit (120 Go en 2-bit), une surface à prévoir pour les poids.
La confidentialité est un atout structurel : tout se passe en local, sur la machine, sans aucun appel distant. Aucun poids ne reste chargé en mémoire au-delà des experts actifs, l’empreinte tourne autour de 6 Go et le risque d’épuisement de RAM est éliminé, les données expert arrivant du SSD à la demande sous la seule gestion du cache de pages du système.
Au final, Flash-MoE repousse les limites de ce qu’un ordinateur portable peut exécuter en local : un modèle de 397 milliards de paramètres, fluide, avec tool calling, sans GPU dédié ni infrastructure cloud. C’est à la fois une prouesse d’ingénierie système — une section résultat détaillant 90+ expérimentations est disponible dans le papier technique — et une démonstration concrète que la mémoire unifiée et le streaming SSD suffisent à démocratiser les très grands modèles. À retenir pour l’écosystème : la performance n’est plus réservée aux serveurs, elle tient désormais dans un sac à dos.