

LINGBOT-MAP : reconstruisez n’importe quelle scène en 3D à partir d’une vidéo, en streaming
https://github.com/Robbyant/lingbot-map
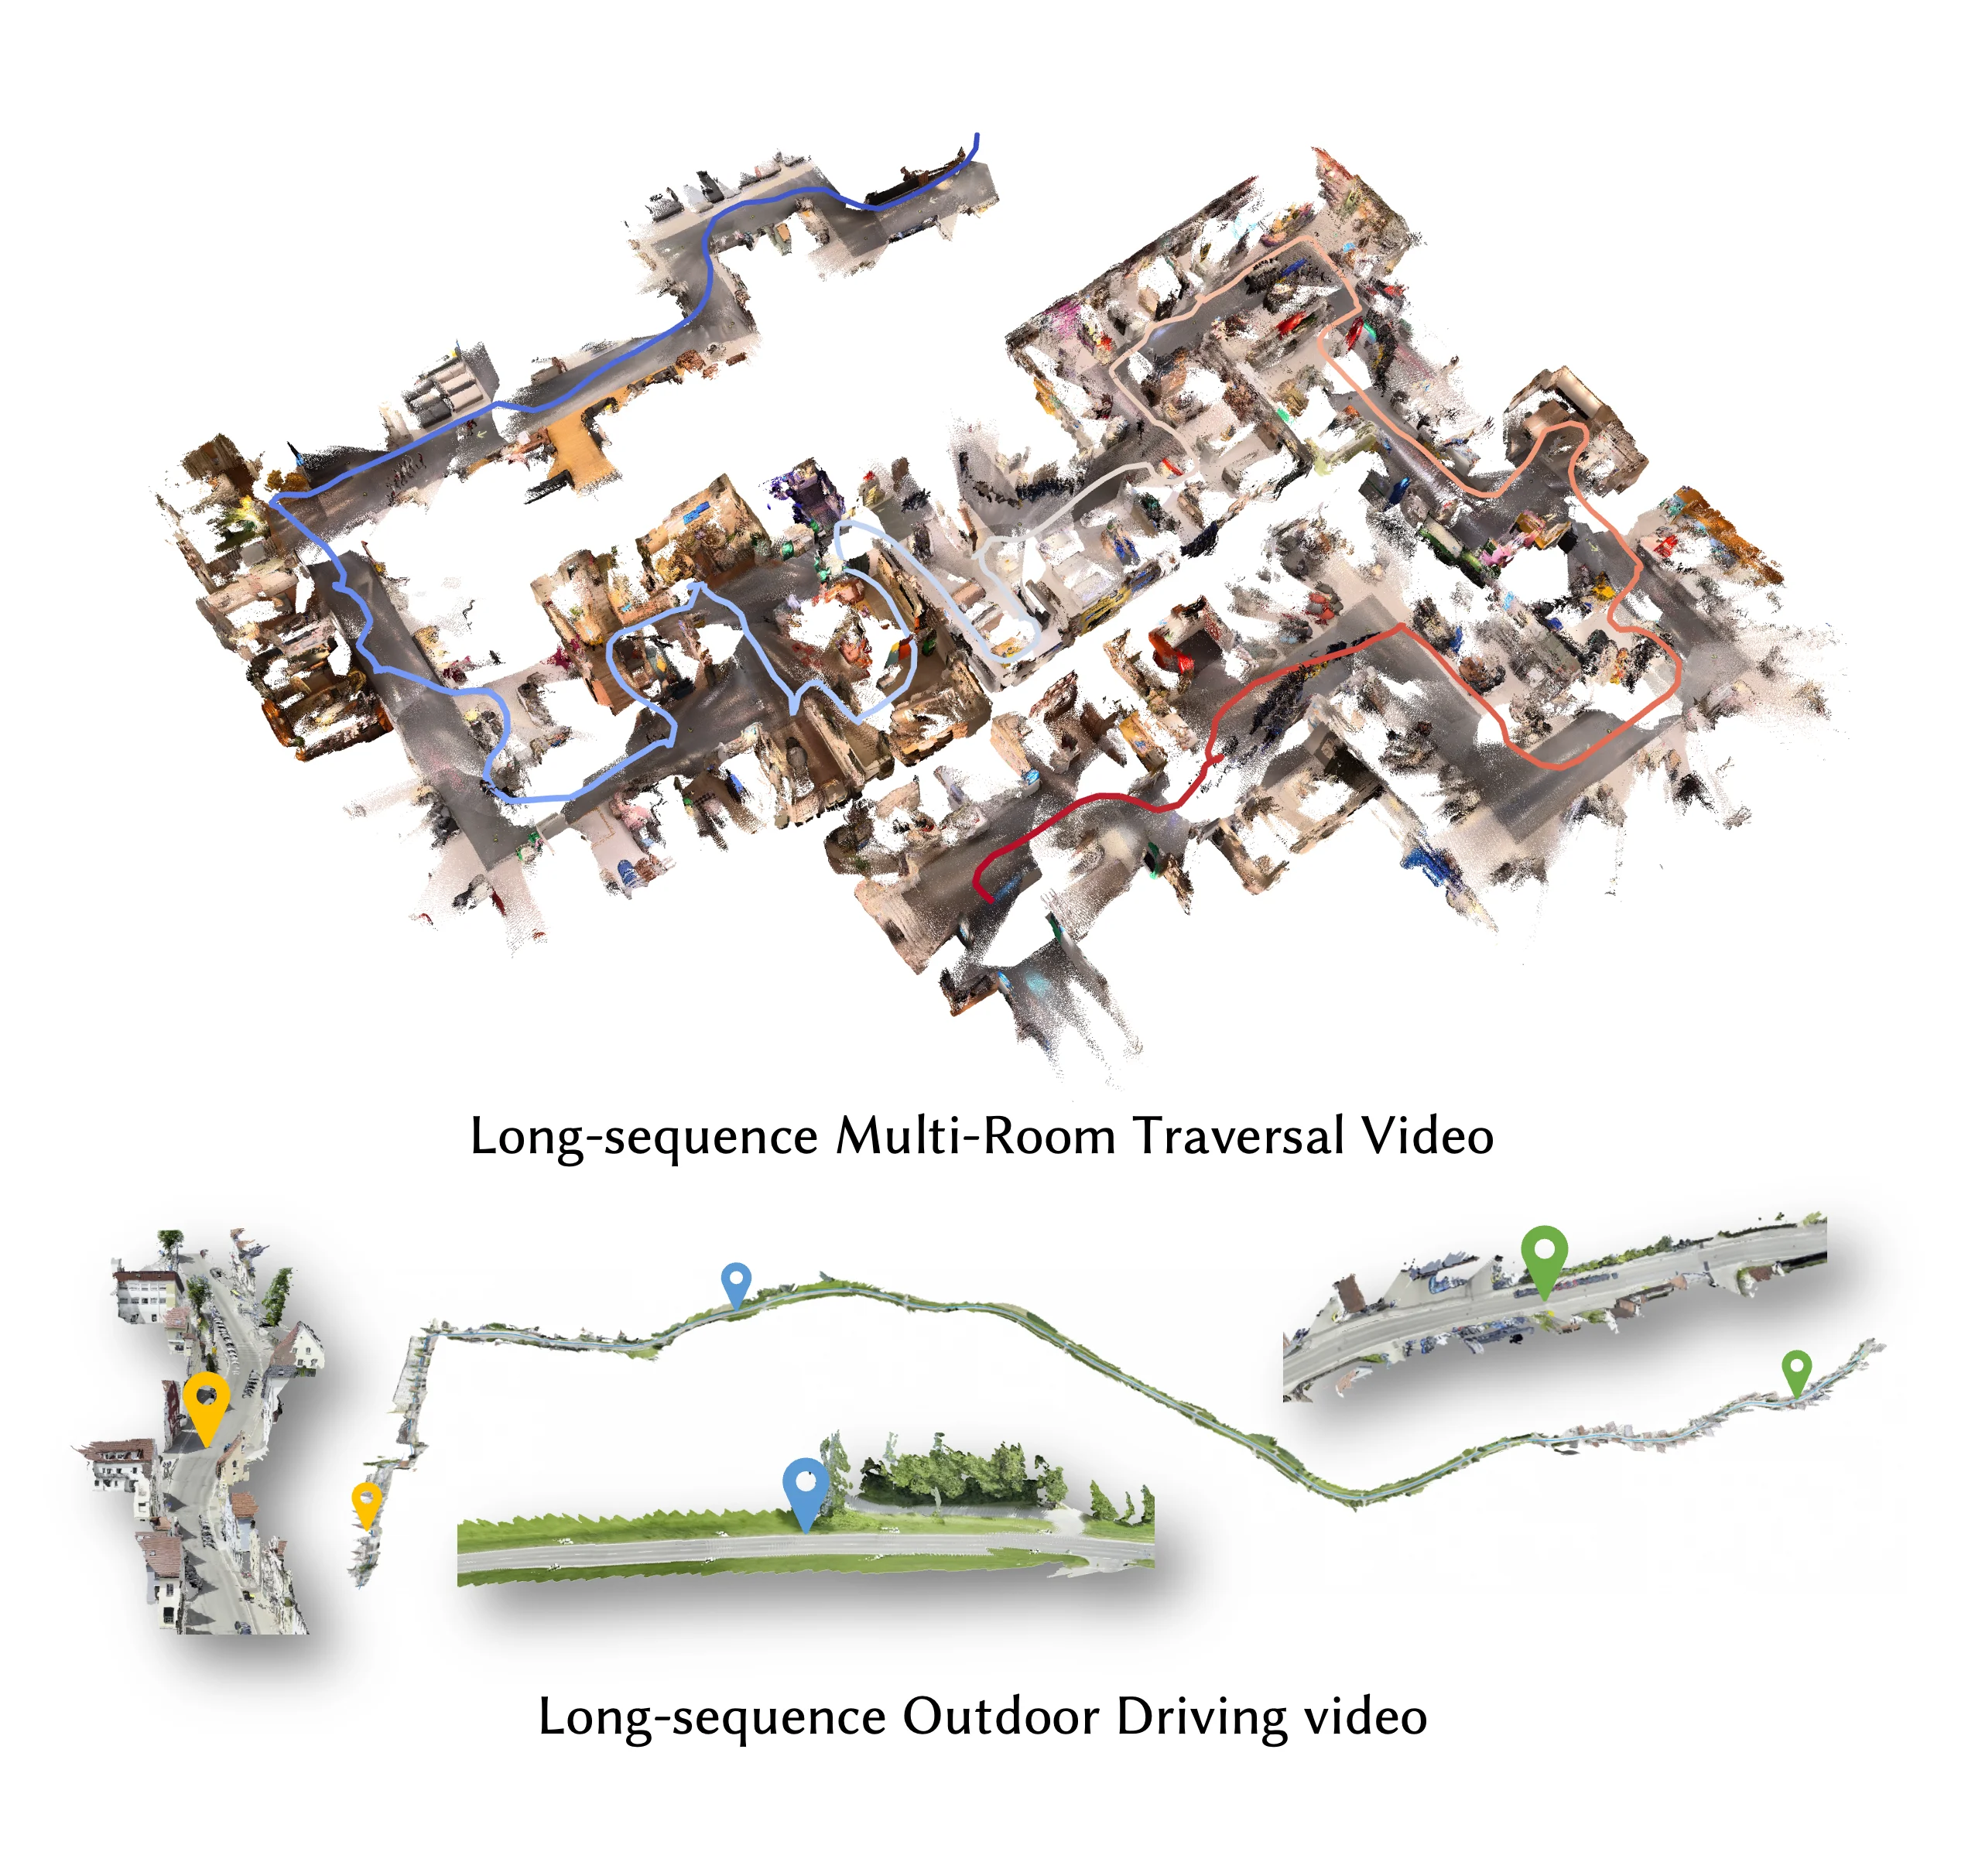
📌 LINGBOT-MAP est un modèle de fondation 3D feed-forward qui reconstruit une scène complète en nuage de points à partir d’un flux vidéo — 25 000 images, 13 minutes de marche en intérieur traitées d’un seul trait, à ~20 FPS sur résolution 518×378.
D’habitude, reconstruire une scène 3D à partir d’une vidéo demande soit du SLAM avec optimisation itérative lourde, soit des approches par lots qui explosent en mémoire au-delà de quelques centaines d’images. LINGBOT-MAP change la donne avec une architecture transformer feed-forward qui traite les images en streaming, une par une, sans reset d’état. Le modèle maintient un contexte géométrique persistant à travers toute la séquence.
Ce que j’ai vu dans les démos
Les vidéos d’exemple parlent d’elles-mêmes. Le parcours intérieur de 13 minutes génère un nuage de points cohérent, sans dérive visible, sans dédoublement des murs. La séquence de conduite en extérieur reconstruit une rue complète avec masquage automatique du ciel. Le modèle gère même des séquences générées par LingBot-World, leur world model — donc ça marche sur du footage réel comme sur du synthétique.
Le banc d’évaluation couvre neuf datasets : KITTI, Oxford Spires, ETH3D, Tanks and Temples, TUM-D, 7-scenes, parmi d’autres. Les résultats battent les approches streaming existantes et les méthodes itératives classiques, d’après le papier arXiv publié en avril 2026.
Comment ça marche
L’architecture — baptisée Geometric Context Transformer — unifie trois choses dans un seul framework : l’ancrage des coordonnées, les indices géométriques denses, et la correction de dérive long-terme. Trois mécanismes la rendent stable sur de longues séquences :
- Anchor context : le modèle garde des points d’ancrage géométriques pour stabiliser le repère.
- Pose-reference window : une fenêtre de référence de pose qui limite la dérive cumulative.
- Trajectory memory : une mémoire de trajectoire qui corrige les dérives longues portée.
Le cache KV paginé (via FlashInfer) permet de garder l’inférence stable au-delà de 10 000 images sans OOM. Un mode fenêtruré (--mode windowed) gère les séquences encore plus longues, avec recouvrement de keyframes entre fenêtres pour préserver l’alignement.
Ce que j’en pense
La prouesse technique est réelle. Faire tenir 25 000 images dans un seul streaming continu, sans reset, à 20 FPS, c’est au-delà de ce que la plupart des pipelines SLAM classiques peuvent offrir. Le fait que le modèle soit feed-forward — pas d’optimisation à la volée — rend le pipeline déterministe et reproductible.
Mon interrogation principale concerne la robustesse hors-distribution. Le modèle est entraîné sur 320 vues avec RoPE vidéo. Au-delà, la performance se dégrade, et il faut basculer en mode fenêtré ou ajuster le keyframe interval. C’est un compromis acceptable, mais à connaître avant de l’utiliser sur des séquences très longues non standards.
Le projet est open source sous Apache 2.0, avec poids disponibles sur HuggingFace et ModelScope. Les scripts de démo (demo.py pour l’interactif, batch_demo.py pour le rendu hors-ligne) sont complets et documentés. L’équipe Robbyant maintient le dépôt activement — corrections de bugs sur le cache KV, benchmark release, nouveaux exemples régulièrement.
Si vous travaillez sur de la reconstruction 3D, de la cartographie robotique, ou du scanning d’espace, LINGBOT-MAP est le projet à tester maintenant.
- 🗺️ Reconstruction 3D streaming feed-forward, pas d’optimisation itérative
- ⚡ ~20 FPS en 518×378, stable sur >10 000 frames
- 🏠 Démo : 25 000 frames, 13 min d’intérieur en un seul passage
- 🧠 Geometric Context Transformer : anchor context + pose-reference + trajectory memory
- 📊 Évalué sur 9 datasets (KITTI, Oxford Spires, ETH3D, Tanks and Temples…)
- 🔓 Apache 2.0, poids sur HuggingFace et ModelScope