

TREG : vos agents cherchent et lisent le web gratuitement
⏱️ Temps de lecture estimé : 3 minutes
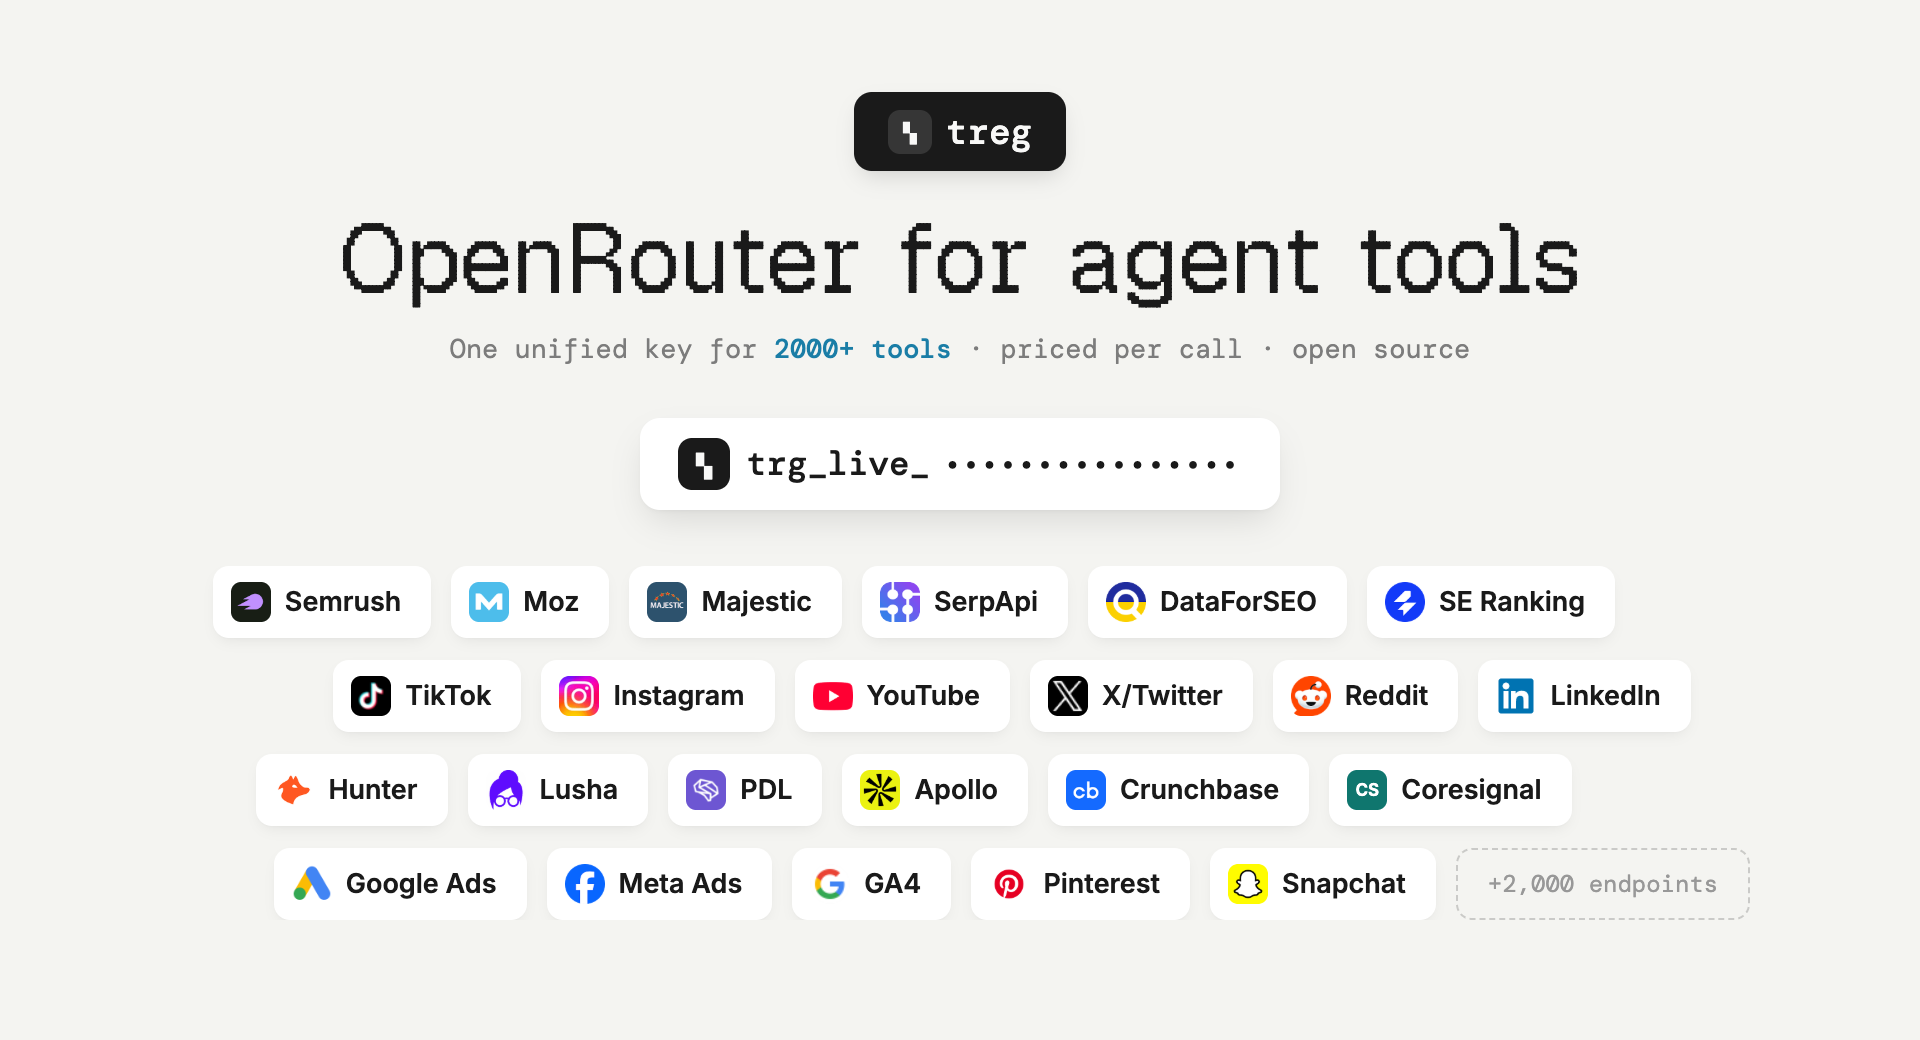
📌 TREG est une API open source qui donne à vos agents la recherche web et la lecture de pages. Le premier appel part chez un fournisseur gratuit. S’il revient vide ou bloqué, treg essaie le fournisseur suivant, jusqu’à la première vraie réponse. Une seule URL, un seul token, aucun plan d’abonnement.
L’exemple concret de la page d’origine : un agent doit lire la fiche Crunchbase de Stripe. L’appel gratuit de TinyFish revient vide. Crawl4AI reçoit un 403. AnyAPI répond pour 0,0007 $. Votre agent, lui, n’a rien changé. Il a demandé un métier, pas un vendeur. treg ordonne les fournisseurs par taux de réussite, prix et vitesse, puis s’arrête au premier qui livre. Un fournisseur facturé à la réussite ne coûte rien quand il rate : le miss est gratuit.
Points clés :
- 🆓 Recherche web et lecture de pages d’abord à $0
- 🔄 Bascule vers le fournisseur suivant quand l’un échoue
- 💰 Plafond de coût par appel avec un simple header HTTP
- 🧾 Traçabilité de chaque appel : qui a répondu, qui a été essayé, combien ça a coûté
- 🛒 Prix, notes et avis produits en JSON, pas en HTML à parser
Quatre en-têtes HTTP pilotent la cascade. X-Treg-Route-Max-Cost pose un plafond par appel — sans lui, une cascade peut monter jusqu’à 1 $. X-Treg-Route-Waterfall sur 0 arrête dès le premier échec. X-Treg-Route-Prefer force un fournisseur en premier, X-Treg-Route-Exclude en écarte un autre. Le corps de la requête reste intact : les options voyagent à côté, jamais dedans.
Ce que j’ai trouvé le plus utile, c’est la traçabilité. Chaque réponse routée porte un bloc _treg : qui a servi l’appel, qui a été essayé avant, ce que chaque tentative a coûté en micro-dollars. Quand une veille se grippe en production, on sait exactement quel fournisseur a lâché et pourquoi. Peu d’API exposent ce niveau de détail sans journal externe.
Au-delà des pages brutes, la même porte d’entrée couvre les réseaux et les boutiques. Un post X, une annonce LinkedIn, un fil Reddit reviennent en champs structurés : auteur, likes, score, nombre de commentaires. Une recherche d’écouteurs compare Amazon, Walmart et eBay avec prix, notes et nombre d’avis côte à côte. Les notes App Store, Google Play et Trustpilot passent par le même endpoint. Les données arrivent en champs, pas en maquette HTML — moins de tokens pour l’agent, et rien à recalibrer quand un site change de design.
L’installation tient en une ligne : npx skills add superdesigndev/treg --skill web-access, ou en pointant simplement votre agent sur treg.to/llms.txt. Le code est open source sous licence Apache 2.0 avec clauses complémentaires : auto-hébergement encouragé, mais pas de redistribution en service hébergé concurrent. Un Web Arena permet enfin de faire s’affronter les fournisseurs de recherche et de lecture sur vos propres requêtes, avec classement des taux de réussite.
Je trouve l’approche solide. Le gratuit d’abord n’est pas un appât : c’est une couche réelle, doublée d’une facturation transparente et d’un contrôle qui reste dans vos mains. Si votre agent doit toucher au web, c’est la porte d’entrée que je choisirais.
Sources
- Site officiel — treg
- GitHub — superdesigndev/treg