

LLAMA : exécutez des LLM locaux sans quitter votre espace de travail
⏱️ Temps de lecture estimé : 2 minutes
https://github.com/ggml-org/Llama-Windows
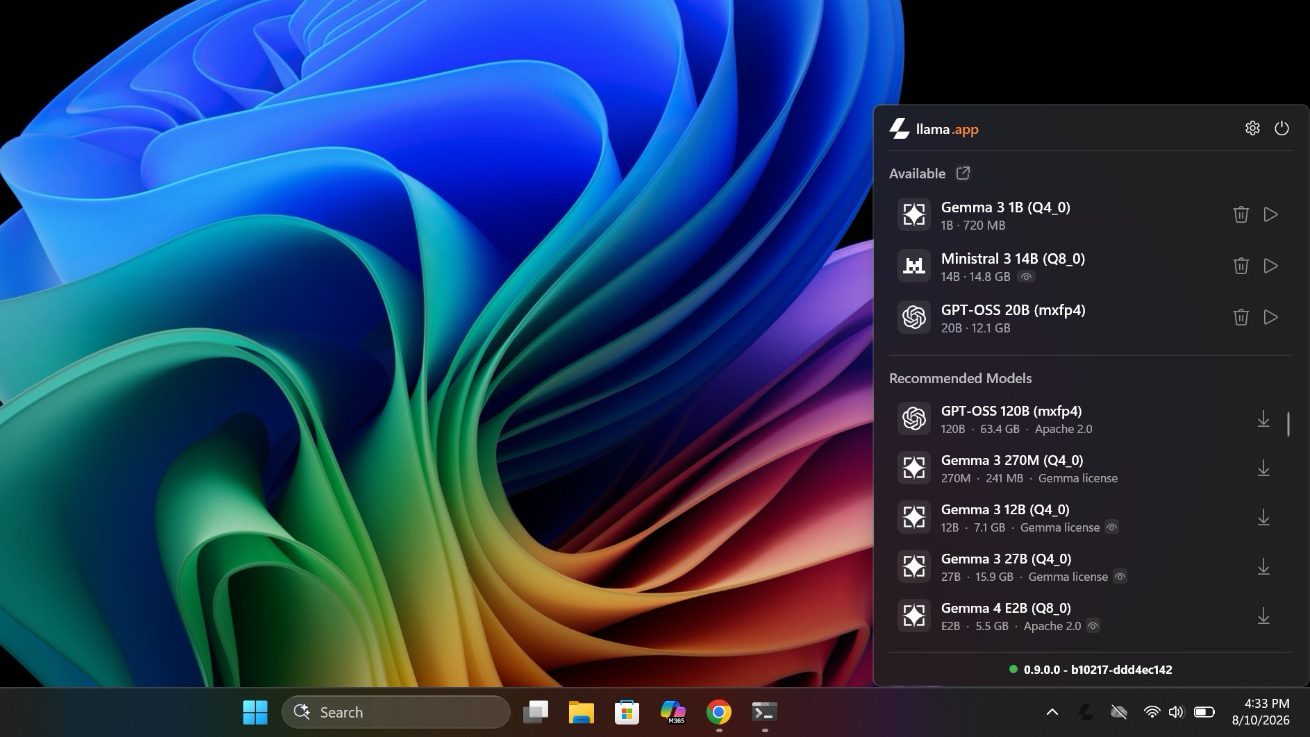
📌 LLAMA est une application Windows 11 qui permet d’exécuter des modèles de langage localement, directement depuis la zone de notification.
L’idée est simple : plutôt que de jongler entre un terminal et des onglets, vous gardez l’accès à votre assistant IA au même endroit que vos icônes système. Le passage d’un outil distant à un outil local change la manière dont vous l’utilisez au quotidien.
Je trouve l’approche intéressante parce qu’elle privilégie la disponibilité plutôt que la complexité. L’interface se limite à une fenêtre volante, accessible en un raccourci, tout en laissant les modèles dans le cache Hugging Face déjà utilisé par llama.cpp. Rien n’est dupliqué inutilement.
L’application gère elle-même le serveur llama serve et dialogue avec lui via son API REST. Vous pouvez aussi utiliser le binaire llama.exe déjà présent sur votre machine, ou le télécharger directement depuis l’app. Côté modèles, un catalogue de recommandations permet de lancer un téléchargement en un clic, tout en conservant la main sur la version choisie.
Le raccourci Alt+Space est le petit détail qui fait la différence. D’un simple appui, une fenêtre sans bordure s’ouvre par-dessus l’application en cours pour discuter avec le modèle chargé. Elle se masque au lieu de se fermer, ce qui conserve la conversation et permet de la réinviter instantanément. Idéal quand vous avez besoin d’un éclaircissement sans rompre votre flux.
Un autre point fort : la confidentialité. Aucun télémetrie, aucun identifiant d’installation. Les seules requêtes sortantes sont les téléchargements de modèles, la vérification de mise à jour et les appels vers le serveur local. Prompts et réponses restent à 100 % sur votre machine. L’app indique d’ailleurs explicitement la version, le build Windows et l’architecture envoyés dans l’User-Agent.
Enfin, la prise en charge des estimations de mémoire par modèle, basées sur l’entête GGUF, évite bien des mauvaises surprises. C’est concret : avant de charger un modèle, vous savez à peu près l’impact sur votre machine. Pour qui veut tester des LLM locaux sans passer par une CLI, c’est l’un des chemins les plus directs sous Windows 11.
Sources