

INDRA OCR : un modèle de 1 million de paramètres qui lit 49 pages par seconde sur CPU
⏱️ Temps de lecture estimé : 4 minutes
https://github.com/datalab-to/indra
📌 INDRA OCR est un package OCR open source construit autour d’un modèle de reconnaissance de 1 million de paramètres. Il convertit PDF et images en markdown, texte ou JSON avec boîtes, entièrement sur CPU, sans GPU ni PyTorch.
Vous connaissez Tesseract. Il reste la référence gratuite pour extraire du texte d’un scan, et l’on finit tous par y revenir. Indra OCR se place face à lui avec une promesse limpide : faire mieux, et beaucoup plus vite, sur le même processeur. Sur OmniParseBench, le benchmark de Datalab, il score 41.3 en texte contre 19.3 pour Tesseract — tout en tournant 24 fois plus vite. À 32 cœurs, la mesure monte à 49 pages par seconde.
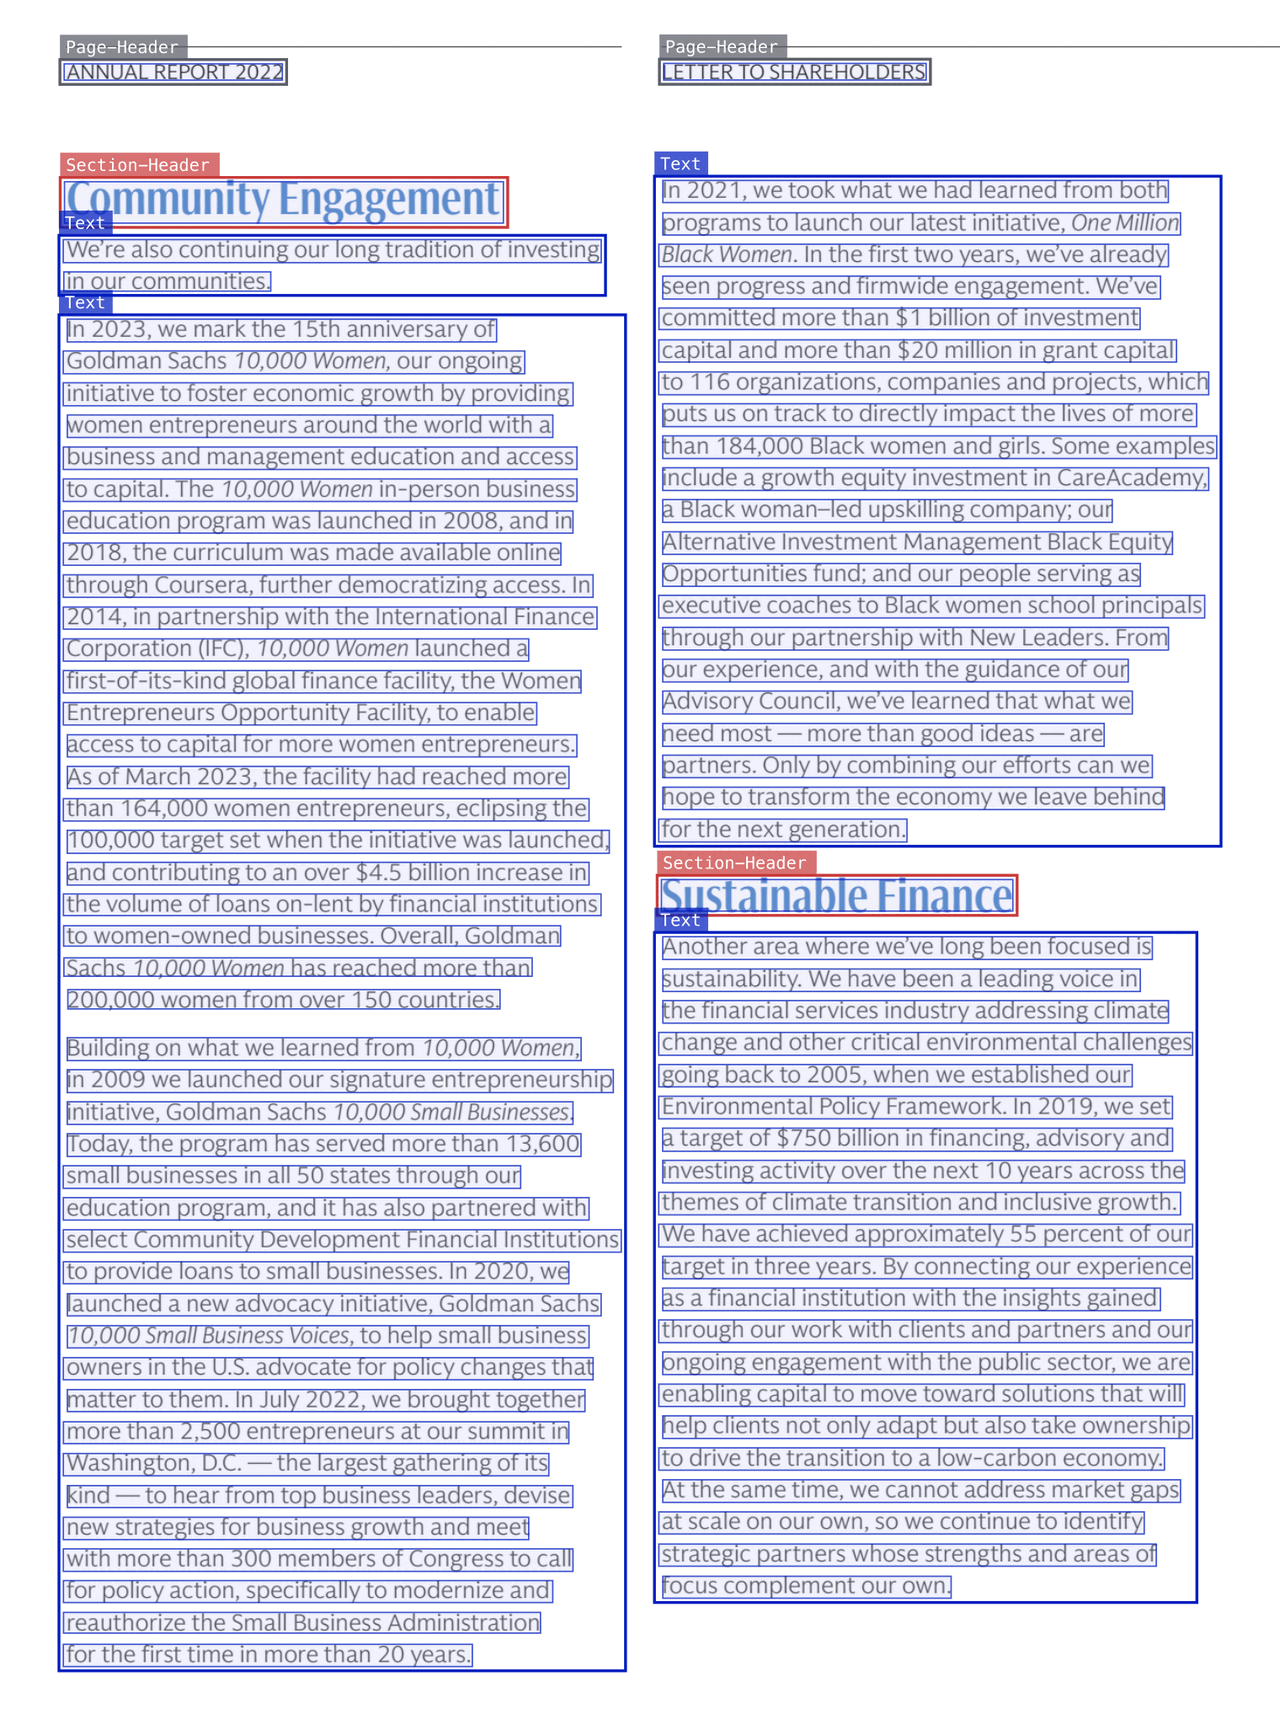
Ce qui change, ce n’est pas seulement la vitesse. Indra OCR rend la mise en page : une boîte englobante par ligne, des blocs de layout étiquetés (titres, listes, tableaux, légendes, notes, en-têtes de page) et l’ordre de lecture. Le markdown sort propre, les tableaux en HTML. Une page scannée à l’envers est redressée avant lecture : l’exemple du dépôt montre une double colonne parfaitement lisible malgré une rotation de 180°.
Le mode par défaut est hybride. Si un PDF numérique expose un calque texte fiable, Indra le lit directement et n’OCRise que ce qui manque. Ces pages prennent environ 130 ms, contre 304 ms pour une vraie page scannée. Le JSON indique l’origine de chaque page — calque, OCR ou les deux — ce que j’apprécie quand on automatise une chaîne : on sait quoi vérifier. Une visionneuse locale, indra-ocr-viewer, laisse déposer un PDF et affiche lignes, blocs et ordre de lecture par-dessus le rendu, confiances et timings compris, sans quitter la machine.
L’installation tient en une ligne : pip install indra-ocr. Les modèles pèsent environ 18 Mo, tournent sur ONNX Runtime et se téléchargent depuis Hugging Face au premier lancement. Python 3.10+, Linux et macOS Apple silicon. L’option --math écrit les formules en LaTeX et fait grimper la note globale de 62.1 à 66.8, au prix de 30 à 35 % de débit en moins.
- ⚡ 49 pages par seconde sur 32 cœurs, sans GPU
- 🗂️ Boîtes de layout étiquetées et ordre de lecture dans le JSON
- 🖥️ Visionneuse locale pour inspecter chaque page
- 🔤 Six familles d’écritures en OCR, tout script via le calque texte
- 🧮 Formules en LaTeX avec l’option
--math - 📦 Environ 18 Mo de modèles ONNX, sans PyTorch
Il faut savoir dire les limites. L’écriture manuscrite n’est pas prise en charge (environ 8 % sur les tests dédiés). Les tableaux complexes à cellules fusionnées perdent leur structure. Sur un scan ou une image, seuls le latin, le cyrillique, le grec, le devanagari, le bengali et le chinois passent ; les autres écritures ne fonctionnent que via le calque texte d’un PDF numérique, et le texte vertical n’est pas géré. Les vieux scans dégradés restent difficiles.
Côté licence, le code est en Apache 2.0 ; les poids suivent une OpenRAIL-M modifiée, gratuite pour la recherche, l’usage personnel et les startups sous 20 M$, mais interdite pour concurrencer l’API de Datalab. Mon avis : le pari du petit modèle est cohérent. Pour trier, indexer ou préparer des documents à un autre modèle, tourner sur CPU change la donne — plus besoin de GPU pour avaler des milliers de pages. La transparence des benchmarks est appréciable : mêmes pages, même machine, résultats reproductibles via le dépôt. Pour la précision maximale sur le manuscrit ou le mathématique ancien, Datalab renvoie vers Chandra, son modèle payant. Indra OCR est l’outil que l’on garde dans le terminal pour le gros du travail.
Sources