

OMNIVOICE : votre voix clonée en local, en français, à partir de 3 secondes d’audio
⏱️ Temps de lecture estimé : 3 minutes
https://github.com/k2-fsa/OmniVoice
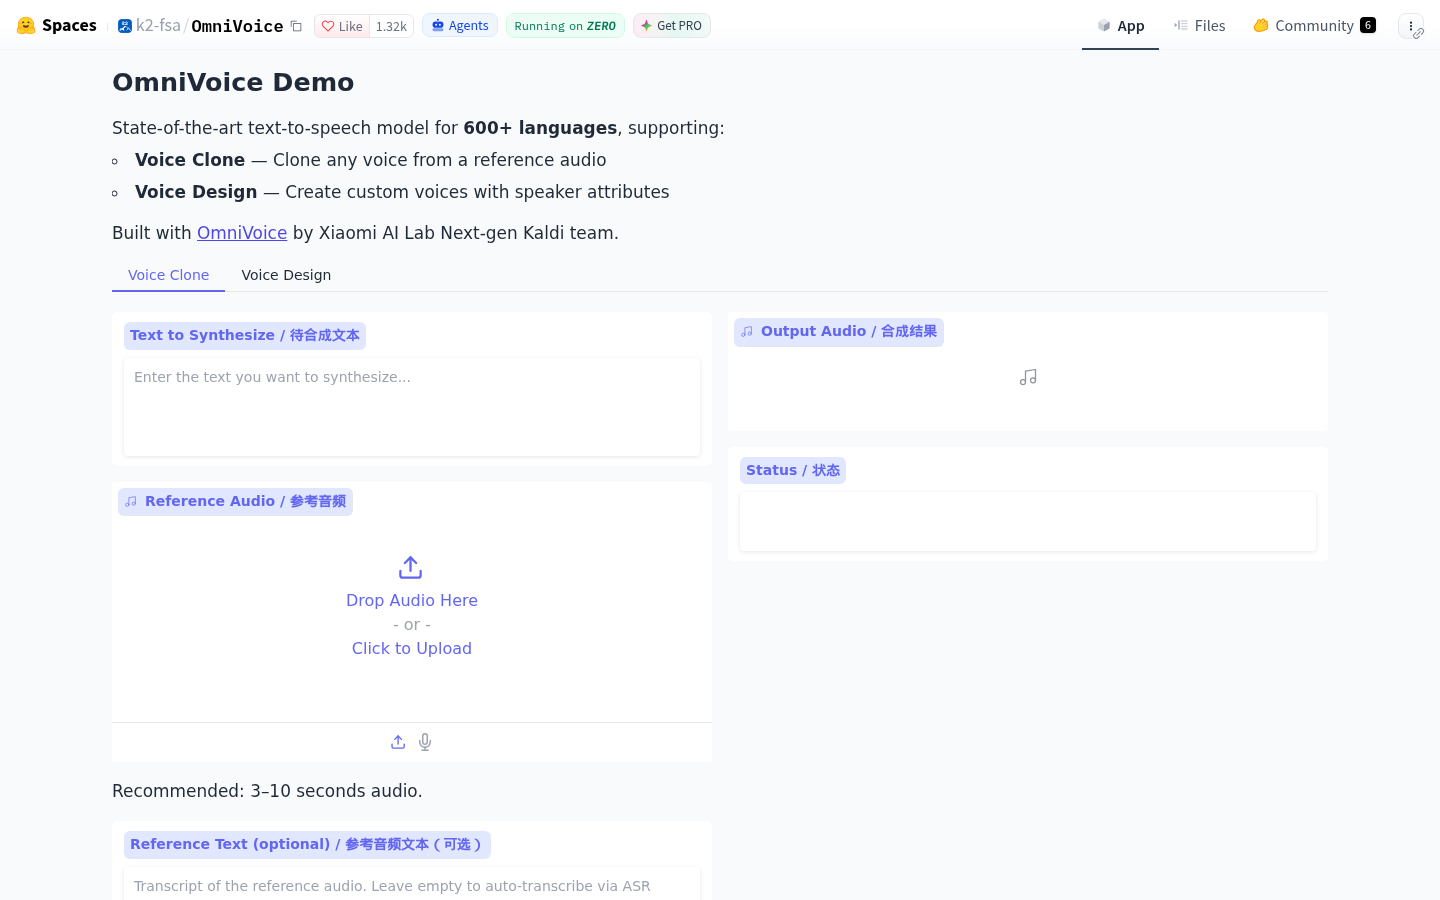
📌 OMNIVOICE est un modèle de synthèse vocale qui reproduit une voix à partir de trois à dix secondes d’enregistrement, dans l’une des 646 langues qu’il couvre. Développé par l’équipe Next-gen Kaldi de Xiaomi, il tourne entièrement sur votre machine, gratuitement, et le français fait partie des langues qu’il a le plus entendues.
Le projet vient de publier son code sur GitHub, où il dépasse déjà les 13 000 étoiles, et ses poids sur Hugging Face. Sous le capot : une architecture de type modèle de langage par diffusion, entraînée sur 581 000 heures d’audio issus de corpus open source. Le français arrive en cinquième position de ce corpus, avec 23 675 heures. Ça s’entend au résultat, loin des robots métalliques des générations précédentes.
Côté usage, tout tient en trois gestes. On découpe un extrait propre de huit secondes avec ffmpeg, sans musique ni hésitations. On écrit mot pour mot ce qu’il dit, ou on laisse Whisper le transcrire. On lance omnivoice-infer avec son texte, et le fichier WAV sort quelques secondes plus tard. Sur un M4 Max, le test de Korben donne 4 à 6 secondes de calcul pour 5,4 secondes d’audio produit. Sans carte graphique, ça fonctionne aussi, mais il faut cinq fois la durée de l’audio en temps de traitement.
- 🎙️ Clonage vocal à partir de 3 à 10 secondes d’audio de référence
- 🌍 646 langues, dont un français nourri de 23 675 heures d’entraînement
- 💻 Mac par puce Apple (MPS), NVIDIA, Intel Arc et même processeur seul
- 🕸️ Interface web Gradio incluse, plus un Space prêt à l’emploi sur Hugging Face
- 🔒 Fonctionne hors ligne : les poids de 3,3 Go se stockent en local, l’audio ne quitte pas la machine
Je trouve l’approche séduisante parce qu’elle ne demande ni compte, ni abonnement, ni envoi de données : on peut télécharger les poids une fois, couper le réseau et générer quand même. Deux précautions tout de même. Pensez à export GRADIO_ANALYTICS_ENABLED=False avant de lancer l’interface web, qui appelle sinon les serveurs de Gradio au démarrage. Et écrivez vos chiffres en toutes lettres : la ligne de commande n’a aucune normalisation de texte, « 2345 » sort n’importe comment.
Une nuance s’impose. Le code est sous Apache 2.0, mais les poids sont en CC-BY-NC : tout usage commercial est exclu. Pour un projet lucratif, l’article de Korben renvoie vers Chatterbox, sous licence MIT, qui parle aussi français et tatoue ses sorties. Autre limite observable : le modèle avale parfois un mot en début ou en fin de phrase — cinq générations sur vingt-quatre lors du test de Korben. On relance, on écoute, on garde la prise correcte.
Pour un usage personnel, OmniVoice fait le travail après quelques minutes d’installation. La voix se sauvegarde en un fichier .pt minuscule et se recharge ensuite sans repasser par l’extrait ni par la transcription. C’est simple, c’est local, et le résultat mérite une écoute avant diffusion.
Sources