

DEVIN CLI : GLM 5.3 Flash débarque dans votre terminal
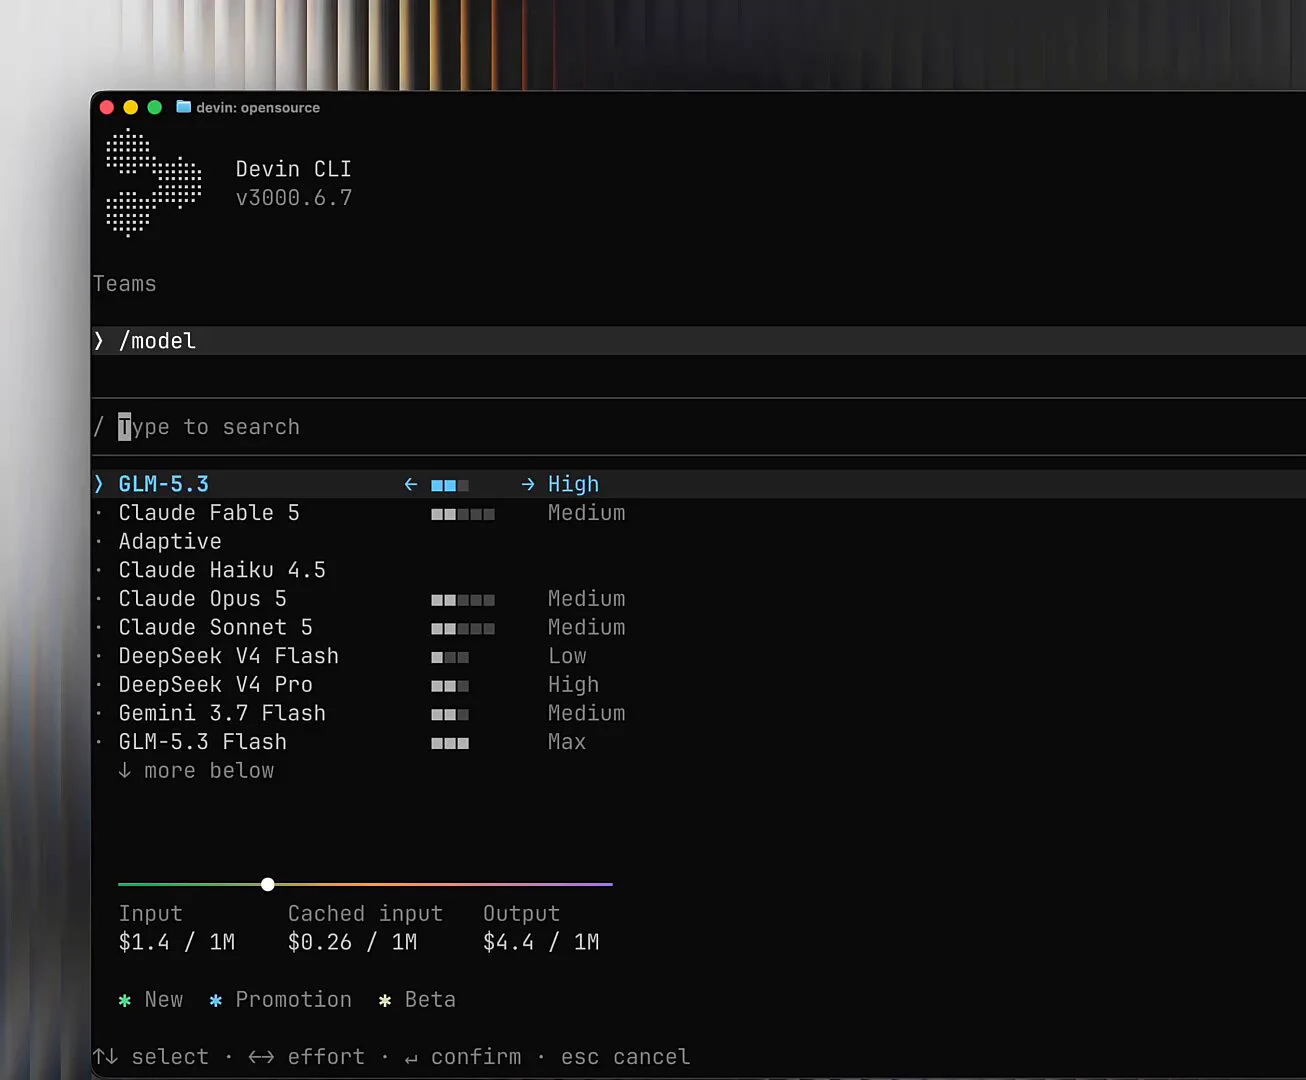
📌 DEVIN CLI est l’agent de code de Cognition qui tourne localement dans votre terminal. La nouveauté du moment : il accueille GLM 5.3 Flash et un sélecteur de modèles repensé, si bien qu’une seule interface donne accès à Claude, GPT, Gemini, Grok, Kimi ou DeepSeek. Installation en une ligne, main vers le cloud quand il le faut.
La démo de l’annonce, avec le nouveau sélecteur de modèles en action :
https://twitter.com/dabit3/status/2094432496142467191/video/1
Devin, on le connaissait surtout comme agent cloud. La déclinaison CLI change la donne : on l’installe avec curl -fsSL https://cli.devin.ai/install.sh | bash, et l’agent travaille directement sur la machine, avec un accès complet au dépôt, aux outils et à l’environnement. C’est pensé pour le travail interactif, pas seulement pour déléguer et attendre. Et comme Il est écrit en Rust, l’équipe pousse la blague jusqu’à dire qu’il tournerait sur un VT100 d’origine.
Le vrai intérêt, c’est le multi-modèle. Il y a quelques semaines, la page officielle citait Opus 4.8, Fable 5, GPT-5.5 et SWE-1.6 comme références. L’annonce publiée ces jours-ci étend nettement la palette : GLM-5.3 et sa déclinaison Flash, Claude Fable, Haiku, Opus et Sonnet, GPT-5.6 en versions Sol, Luna et Terra, DeepSeek V4 (Flash et Pro), SWE-1.7 et 1.6, Gemini 3.7 Flash, Grok 4.6 et 4.5, Inkling, Kimi K3 et 2.7, et d’autres encore. Le tout est aussi disponible dans Devin Desktop, avec un sélecteur de modèles dont l’ergonomie vient d’être retravaillée.
Je trouve l’approche pragmatique : plutôt que de jurer sur un seul modèle, on garde un agent et on change de moteur comme on change de lunettes, selon le compromis coût et qualité du moment. La déclinaison Flash de GLM 5.3 en est l’exemple typique, rapide et légère pour les tâches courantes, à réserver côté cloud pour les gros chantiers. Une nuance honnête : tous ces modèles ne sont pas forcément actifs partout ni en même temps, et la liste complète vient de l’annonce, pas encore de la page d’accueil.
Au-delà du terminal, le handoff reste le point fort : on lance la session en local, puis on confie le reste à Devin Cloud, qui démarre sa propre VM, lance les tests, enregistre la session en vidéo, corrige seul, et vous rend une pull request prête à fusionner. On revient à un travail fini.
Si vous voulez essayer : une ligne de curl suffit, puis on choisit son modèle dans le panneau. Pour une équipe qui jongle déjà entre plusieurs fournisseurs, éviter de changer d’outil à chaque mode me semble un vrai gain de temps.
Points clés :
- 💻 Agent IA qui tourne localement dans le terminal (Rust)
- ⚡ GLM 5.3 Flash et un sélecteur de modèles repensé
- 🧠 Claude, GPT, Gemini, Grok, Kimi, DeepSeek et Inkling au menu
- 🔁 Main vers Devin Cloud : VM, tests, vidéo, autofix, PR finie
- 🪶 Variante Flash pour les tâches rapides et légères
Sources :